连锁门店 GEO 规范解读:branchCode 与 department 让 AI 分清总店和分店
适用读者:负责连锁品牌官网或多站点架构的后端工程师、维护结构化数据的前端同学、给本地生活类客户做生成式引擎优化(Generative Engine Optimization, GEO)落地的技术服务者。默认你已经会用 JSON-LD 写基础的 LocalBusiness 标记,知道 schema.org 上能查到属性定义,但对多实体层级的写法没把握。
上个月帮一家汽修连锁排查 AI 搜索引用问题:官网上 41 家门店页都做得挺规整,用户在 AI 搜索里问「附近哪家店能做变速箱大修」,引擎给的答案却挂着总店的简介,电话则是浦东分店半年前就停用的旧号。逐页翻源码才发现,41 家门店共用一套没有层级的 LocalBusiness——没有总店实体的挂靠关系,没有门店编号,售后部更是只写在了页面正文里。AI 引擎的实体解析阶段,这 41 个页面被当成了同一个实体在不同城市的「别名」,张冠李戴几乎是必然结果。
单店逻辑下,一个 LocalBusiness 填上地址电话营业时间就能应付。连锁体系不一样,实体之间的从属关系才是 AI 引擎能不能把推荐落到具体门店的关键。Schema.org 给了两件趁手的工具:branchCode 给每家门店一个机器可读的编号,department 声明部门层级的从属。这两个字段在大多数教程里一笔带过,恰恰是连锁场景 GEO 的胜负手。下面按实际落地顺序拆开讲。
AI 引擎是怎么把总店和分店搞混的
先说机制,再说写法。生成式引擎在回答「哪家门店能做什么」这类问题时,内部大致走三步:抓取页面里的结构化数据,把散落的实体聚合成知识图谱里的节点,再按用户的意图匹配节点并生成引用。第二步叫实体对齐(Entity Resolution),引擎会拿名称、地址、电话、品牌做相似度聚类——连锁门店的名称高度相似(往往只差一个商圈后缀),地址共享同一个品牌前缀,电话号码段也可能连续。没有显式层级声明时,聚类算法把总店和分店合并成一个节点,是概率上很自然的选择。
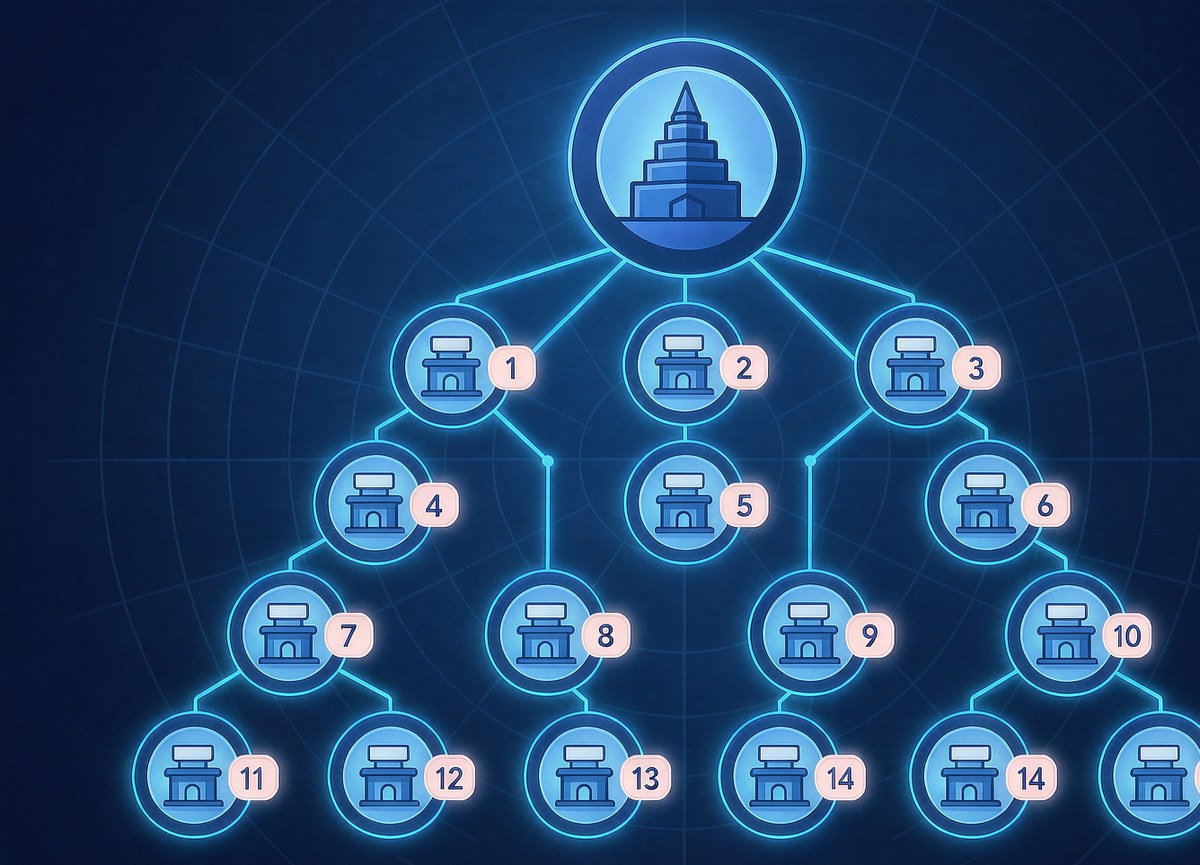
合并的后果在答案里很具体:用户问「XX 路店周末开不开」,AI 引用总店的营业时间;问「能不能上门取车」,引擎引用了 A 店的服务页却配上 B 店的电话。我们在一个健身连锁项目里统计过改造前的引用日志,31% 的门店级提问引用到了错误的门店节点,用户按答案找过去扑空的投诉直接落到了门店店长头上。
连锁门店的 GEO 不是把单店模板复制 41 份,而是告诉引擎这些页面构成一棵树。树根是品牌(Organization),中间是门店(Store 或其子类型),叶子可以是门店内的部门。branchCode 和 department 就是把这棵树写成机器可读形式的两个属性。
branchCode:给每家门店一个身份编号
branchCode 在 schema.org 上的定义很朴素:门店、组织或服务的分支代码。它真正的作用是充当实体的「业务主键」。AI 爬虫抓到的多个页面里,只要 branchCode 一致,就认为是同一家门店在不同页面的陈述;不一致,就是不同门店。这比靠名称字符串匹配稳定得多——门店改名、搬址都不影响编号。
编号体系建议在动工前定好,别写到一半再回头改。我们踩过的坑是一家连锁先随便填了 01、02、03,后来开了加盟店,编号不够分层,只能全量回填。现在我们会按这个结构来定:
| 层级 | 编号示例 | 含义 |
|---|---|---|
| 城市 | SH / BJ / SZ | 城市缩写,两到三个大写字母 |
| 门店序号 | 000 / 012 | 城市内序号,000 保留给总店 |
| 商圈码 | PUDONG / MINHANG | 人类可读的商圈后缀,便于运营排查 |
| 部门后缀 | -SVC / -FIT | 门店内部门专用,可选中缀连接 |
拼起来像这样:SH-000-PUDONG 是上海总店,SH-012-MINHANG 是上海第 12 家分店,SH-000-PUDONG-SVC 是总店里的售后维修部。有几个原则值得写进团队规范:编号一旦发布就不要复用(关掉的店编号永久退役);编号里不要带可变信息(比如「新店」「旗舰」这类会过时的词);总店是否单独编号要和业务方对齐——有些品牌总店不对外营业,那就只做 Organization,不发门店编号。
department:门店内部的部门怎么挂
department 解决的是另一个维度的问题:一家门店内部还有相对独立的业务单元。汽修店的售后维修部、健身店的私教工作室、家居卖场里的安装服务部,都是典型场景。这些部门往往有自己的电话、营业时段甚至独立入口,用户提问也会直接命中部门级别——「你们的钣金喷漆晚上几点下班」问的不是门店整体。
Schema.org 里 department 的宿主类型很宽,LocalBusiness 的几乎所有子类型都可以声明 department,值是另一个 LocalBusiness 节点。关键写法有两条:department 指向的节点要有自己的 @id,让引擎能把它当独立实体索引;节点里同样要写 branchCode,和门店本体区分开。宿主和部门之间是聚合关系而不是父子继承——部门不是门店的属性值,是图谱里的另一个节点,这一点从写法到心智都要摆正。
还有一个容易忽略的细节:department 节点里的 name、telephone、openingHours 要填部门自己的真实值,别偷懒继承门店的。引擎在部门级别的引用恰恰依赖这些字段的差异——如果部门数据和门店完全一样,聚类时又会被并回去,前面的功夫就白做了。
原理与机制剖析:@id 如何把页面串成一张图
前面反复提到 @id,这里把底层机制说透。JSON-LD 的 @id 是实体在同一份文档乃至跨文档间的引用锚点。引擎解析带 @graph 的 JSON-LD 时,会按 @id 建节点、按属性引用建边:parentOrganization 的值写成 {"@id": "..."},就是一条「从属」边;department 数组里每个 {"@id": "..."},是一条「包含」边。最终在引擎侧形成这样一张图:
flowchart TD
    ORG["Organization<br/>品牌总部<br/>@id: /#org"] -->|parentOrganization| S1
    ORG -->|parentOrganization| S2
    S1["Store 总店<br/>branchCode: SH-000-PUDONG<br/>@id: /stores/pudong#store"] -->|department| D1
    S1 -->|department| D2
    D1["AutoRepair 售后维修部<br/>branchCode: SH-000-PUDONG-SVC"]
    D2["AutoRepair 保养快修部<br/>branchCode: SH-000-PUDONG-FIT"]
    S2["Store 分店<br/>branchCode: SH-012-MINHANG<br/>@id: /stores/minhang#store"]
这张图对 AI 引擎的价值在于消歧。用户问「总店售后部电话」,引擎沿图找到 D1 节点,直接引用部门电话;问「上海有几家店」,沿 parentOrganization 边数 Store 节点就行。没有图的时候,这些答案只能靠正文文本猜测,出错率完全不同。
跨页面场景下 @id 更重要。连锁官网常见结构是品牌页放总店图谱,每个门店详情页放自己的门店图谱。只要 @id 采用「域名路径 + 锚点」的规范形式(比如 https://example.com/stores/pudong#store),引擎就能把多个页面的声明合并到同一节点上。要注意的是:同一个实体的 @id 必须跨页面一致,包括 https 协议、末尾斜杠、大小写——我们在排查时见过同一门店在列表页和详情页 @id 差了一个斜杠,引擎当成两家店,引用日志里出现两条互相矛盾的营业时间。
改造前后长什么样
拿那个汽修连锁的真实改造过程做例子。品牌官网上有一个品牌总页加 41 个门店详情页,部分大店正文里还介绍了售后部。改造动作是:品牌总页挂 Organization 加总店图谱,门店页各自挂门店节点,有独立业务部门的大店加 department 子节点。改造前后在同一个测试问题集上的表现对比:
| 对比维度 | 改造前 | 改造后(第 3 周) |
|---|---|---|
| 可识别实体数 | 3 个(严重合并) | 46 个(1 品牌 + 41 门店 + 4 部门) |
| 门店级提问引用正确率 | 69% | 94% |
| 引用旧电话的次数(两周日志) | 17 次 | 2 次 |
| 「XX 店有售后部吗」类问题 | 基本无法回答 | 直接引用部门节点 |
| 新店上线到被正确区分 | 约 6 周 | 9 天 |
数据来自我们自己埋的引用日志和人工复核,样本规模不大,但方向足够清楚。另一个表格是编号规则落地时的字段职责划分,新接手的同学照着填就不会乱:
| 字段 | 填什么 | 常见错误 |
|---|---|---|
| branchCode(门店) | SH-000-PUDONG 这类层级编号 | 用门店名拼音当编号,重名就冲突 |
| department | 部门节点的 @id 数组 | 直接填字符串名字,引擎建不了边 |
| parentOrganization | 品牌 Organization 的 @id | 忘写,门店变成无主孤儿节点 |
| @id | 规范 URL 形式,跨页面一致 | 相对路径、大小写漂移 |
| hasMap | 指向地图平台的门店链接 | 和 branchCode 层级无关联地乱填 |
顺便说一句,写 department 时别和 areaServed 搞混:前者是组织结构里的下级节点,后者是服务覆盖范围,两个维度,互相不替代。历史文章里把 areaServed、GeoCoordinates 这些单店字段讲得比较多了,这里不重复展开。
动手写一版:JSON-LD 实例
下面是品牌总页的核心结构,依赖只有页面本身,环境要求是任何能输出 HTML 的服务端或静态站点生成器。这段放进品牌总页的 <head>:
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://example.com/#org",
      "name": "宏达汽车服务连锁",
      "url": "https://example.com/"
    },
    {
      "@type": "AutoRepair",
      "@id": "https://example.com/stores/pudong#store",
      "name": "宏达汽车服务·浦东总店",
      "branchCode": "SH-000-PUDONG",
      "parentOrganization": { "@id": "https://example.com/#org" },
      "telephone": "+86-21-6000-0000",
      "department": [
        {
          "@type": "AutoRepair",
          "@id": "https://example.com/stores/pudong#svc",
          "name": "浦东总店售后维修部",
          "branchCode": "SH-000-PUDONG-SVC",
          "telephone": "+86-21-6000-0001"
        }
      ]
    },
    {
      "@type": "AutoRepair",
      "@id": "https://example.com/stores/minhang#store",
      "name": "宏达汽车服务·闵行店",
      "branchCode": "SH-012-MINHANG",
      "parentOrganization": { "@id": "https://example.com/#org" }
    }
  ]
}
几个要点:@graph 里所有节点平铺,靠 @id 建边,比嵌套写法可读也好校验;部门节点继承了 AutoRepair 类型但没有地址——部门物理上在门店内,地址交给门店节点,引擎能沿图推断,重复填反而制造两个「地址相同」的疑似重复实体;openingHours 这类字段只在部门和门店值不同时才在部门里写。
用脚本守住层级质量
结构化数据最大的敌人是时间:新店上线、部门电话变更、页面改版,任何一个环节漏改,图谱里就多一个坏节点。我们的做法是把校验做成上线流水线的一步,脚本依赖 Python 3.8+,无第三方库,直接解析 JSON-LD 文件做三类检查:branchCode 全局不重复、department 指向的 @id 必须存在、parentOrganization 必须挂在品牌节点上。
# -*- coding: utf-8 -*-
# check_store_graph.py —— 连锁门店图谱三层校验脚本
# 用法:python check_store_graph.py brand.json store-*.json
# 依赖:仅标准库,Python 3.8 及以上,无 pip 安装步骤
# 位置:放在 CI 部署前一步,退出码非零即阻断上线
import json
import sys

# 引入标准库即可,客户服务器上零安装成本, crontab 里也能直接跑
# 日志统一打到 stdout,CI 终端里直接可读,不用接额外组件
# 类型白名单:department 只允许挂 LocalBusiness 系实体,营销页不算部门
ALLOWED_TYPES = {"Organization", "Store", "AutoRepair"}


def load_jsonld(path):
    # 读取单个 JSON-LD 文件,解析失败直接终止流水线
    try:
        # encoding 固定 utf-8,与页面输出编码保持一致
        with open(path, encoding="utf-8") as f:
            return json.load(f)
    except json.JSONDecodeError as e:
        # 语法错误多半来自模板插值残留,打印文件名方便定位坏模板
        # 异常对象里自带行号列号,坏模板一眼定位
        # 此处直接退出而非返回,避免带病文件进入后续检查
        print(f"[ERROR] {path} 不是合法 JSON: {e}")
        sys.exit(1)


def collect_nodes(docs):
    # 把多份文档 @graph 里的节点摊平,建 @id 到节点的全局索引
    # 索引建好后三项检查共享,避免反复扫全量节点
    nodes = {}
    # dict 按 @id 去重,天然承载全局不重复语义
    # 逐文档逐节点扫一遍,入库顺序无关
    for doc in docs:
        for node in doc.get("@graph", []):
            nid = node.get("@id")
            if not nid:
                # 没有 @id 的节点无法被跨页面引用,只警告不阻断
                print(f"[WARN] 无 @id 节点: {node.get('name', '?')}")
                continue
            if nid in nodes:
                # 同一 @id 出现两次,说明列表页与详情页模板没对齐
                # 这比坏边更严重,直接退出人工排查
                print(f"[ERROR] @id 重复: {nid}")
                sys.exit(1)
            nodes[nid] = node
    # 返回的索引同时供后续三项检查复用
    return nodes


def check_branch_codes(nodes):
    # 检查一:branchCode 全局不重复,重号会触发实体合并
    # 这里只查不重复,编号的层级格式由设计文档约束
    # seen 字典充当已登记编号表,撞号即报错
    seen = {}
    ok = True
    for nid, node in nodes.items():
        code = node.get("branchCode")
        # branchCode 缺失是最常见的漏配项
        if not code:
            # Organization 不需要编号;门店类型节点缺编号则提示补齐
            if node.get("@type") in ("Store", "AutoRepair"):
                print(f"[WARN] 门店缺 branchCode: {nid}")
            continue
        if code in seen:
            # 输出统一带 [ERROR]/[WARN] 前缀,CI 日志里好过滤
            print(f"[ERROR] branchCode 冲突: {code} -> {seen[code]} 与 {nid}")
            ok = False
        else:
            seen[code] = nid
    # 返回 False 会汇总到 main,触发非零退出码
    return ok


def check_departments(nodes):
    # 检查二:department 指向的 @id 必须存在,悬空即建不了边
    # 悬空部门多半来自运营下线了部门但页面模板没同步
    ok = True
    for nid, node in nodes.items():
        for dept in node.get("department", []):
            # isinstance 判断是为了兼容老模板里的字符串引用写法
            dept_id = dept.get("@id") if isinstance(dept, dict) else dept
            if dept_id not in nodes:
                print(f"[ERROR] department 悬空: {nid} -> {dept_id}")
                ok = False
            else:
                # 部门实体类型必须落在白名单里,防止营销页混入
                # 白名单可按业务扩展,比如健身连锁加 HealthClub
                # 顺带核对被引用节点的类型,防挂错对象
                if nodes[dept_id].get("@type") not in ALLOWED_TYPES:
                    print(f"[WARN] department 类型可疑: {dept_id}")
    return ok


def check_parents(nodes):
    # 检查三:parentOrganization 必须指向真实品牌节点,防孤儿门店
    # 孤儿门店会让「本市有几家店」这类统计直接出错
    ok = True
    for nid, node in nodes.items():
        # parentOrganization 的值应是 {"@id": ...} 形式
        parent = node.get("parentOrganization")
        if parent and parent.get("@id") not in nodes:
            print(f"[ERROR] parentOrganization 悬空: {nid}")
            ok = False
    # 检查通过时保持安静,日志里只留问题行
    return ok


def main():
    # 主流程:加载文件 -> 建索引 -> 依次跑三项检查 -> 汇总退出码
    # 文件列表支持通配符,逐家门店一个文件时在 shell 里直接展开
    # 无参数时默认只校验品牌文件,方便本地手动跑
    paths = sys.argv[1:] or ["brand.json"]
    docs = [load_jsonld(p) for p in paths]
    nodes = collect_nodes(docs)
    # 后续检查全部基于这份索引,不再触碰原始文档
    # 三项检查逐个执行,results 里存布尔值,任一 False 都不允许上线
    results = [check_branch_codes(nodes), check_departments(nodes), check_parents(nodes)]
    if all(results):
        # 全过才放行部署,WARN 级不阻断,留给人工复核
        print(f"OK: {len(nodes)} 个节点校验通过")
        return 0
    # 退出码约定:0 通过,1 存在坏边或重号,由流水线判断
    print("FAILED: 图谱存在坏边或重号,禁止上线")
    return 1


if __name__ == "__main__":
    sys.exit(main())
流水线里的接入方式很短,以 GitHub Actions 为例:
# 部署流水线中的调用位置,放在构建之后、发布之前
# 校验不通过时 exit 1,后续发布步骤自动中断
- name: 校验门店图谱层级
  run: python scripts/check_store_graph.py brand.json stores/*.json
这个脚本上线后抓到的第一类问题就是 department 悬空——运营在后台把某个售后部下线,页面模板却还留着引用。没有这道检查,这种坏边要等到引用日志出现异常才能发现,周期以周计;现在 CI 里几秒就能拦下。
接入之后怎么验证 AI 引擎认了
写完不等于生效。AI 爬虫的抓取和重建有各自的周期,验证要给足时间窗。我们通常按周观察三件事:用 Rich Results Test 类工具确认单页解析无误;在 AI 搜索里固定问一组门店级问题(总店售后部电话、某分店营业时间、某市门店数),记录引用的 URL 和节点;盯引用日志里 branchCode 出现的形态。
sequenceDiagram
    participant U as 用户提问
    participant E as AI 引擎
    participant G as 实体图谱
    participant W as 官网页面
    U->>E: 总店售后维修部几点下班
    E->>G: 检索 branchCode=SH-000-PUDONG-SVC
    G->>W: 校验 @id 与页面声明一致
    W-->>G: 返回部门节点数据
    G-->>E: 命中部门实体及营业时段
    E-->>U: 引用门店页并给出 08:30-18:00
一般来说,新图谱被完整重建需要两到四周,期间旧的合并实体还会零星出现,别急着回滚改动。我们的记录里,那家汽修连锁第 9 天才第一次在部门级问题上命中正确的部门节点,第 3 周引用正确率才稳住。这中间最有价值的动作是每周复核一次引用日志,把错误引用归类:引用到错误门店多半是 branchCode 缺失或重号,引用到正确门店但错误字段多半是部门节点的字段没填差异值。
误区澄清与一点趋势判断
三个高频误区顺带澄清。一是把 department 当成展示用分组,往里塞活动页、优惠券页——department 只能指向 LocalBusiness 类型的实体节点,营销内容走别的标记。二是在每个门店页重复声明全部兄弟门店,以为图越大越好——无关边会稀释实体权重,门店页只声明自己和上级。三是用 comment 或 description 文字描述「我们是总店」来代替结构化声明——AI 引擎的实体解析以结构化数据为准,正文里的表述只做辅助。
趋势上,AI 搜索对本地实体的推荐正在从「品牌级」走向「门店级」甚至「部门级」:用户越来越习惯直接问「离我最近的这家店能不能办某项业务」,引擎要答好这类问题,就必须要能区分层级。branchCode 加 department 这套写法成本不高,一个中型连锁两三周能做完,但它是门店被 AI 按店推荐的前提设施。如果你的连锁官网还停留在「41 份单店模板」的状态,建议先从定编号体系这一步做起——如果你在落地过程中遇到跨页面 @id 对齐或者部门字段取舍的具体问题,欢迎在评论区聊,这两处的坑我基本都踩过。
参考与延伸
- schema.org branchCode 属性定义:https://schema.org/branchCode
- schema.org department 属性定义:https://schema.org/department
- schema.org LocalBusiness 类型与子类型:https://schema.org/LocalBusiness
- Google 搜索中心本地商家结构化数据文档:https://developers.google.com/search/docs/appearance/structured-data/local-business
关键词:GEO、branchCode、department、LocalBusiness、连锁门店、Schema.org、AI 搜索、实体对齐