带参数的小程序码是运营的隐形入口:wxacode.getUnlimited 批量生成与场景值追踪实战
适用读者:负责连锁门店「一店一码」落地的微信小程序开发者、需要给地推物料批量出图的运营技术对接人、维护 access_token 中控服务的后端工程师。
三百多家门店的桌贴和传单一晚上印出去了,运营第二天来问:每个店扫了多少码、哪个渠道带来的注册最多?答不上来。因为印上去的是不带参数的小程序码,所有人扫码都落首页,来源混在一起根本拆不开。这个故事在一半做连锁业务的小程序团队里都发生过,解法其实只有一个:用 wxacode.getUnlimited 给每家店、每场活动生成独立的带参小程序码,让入口自己报数。
运营要的不是一张码,是一个可归因的入口
一张普通小程序码指向某个 page,用户扫码后进入的是固定的落地页。对单门店的小店来说够用了,但只要业务有「多门店」或「多渠道」任意一个维度,不带参数的码就失去了分析价值——你只知道有人来了,不知道他从哪来。
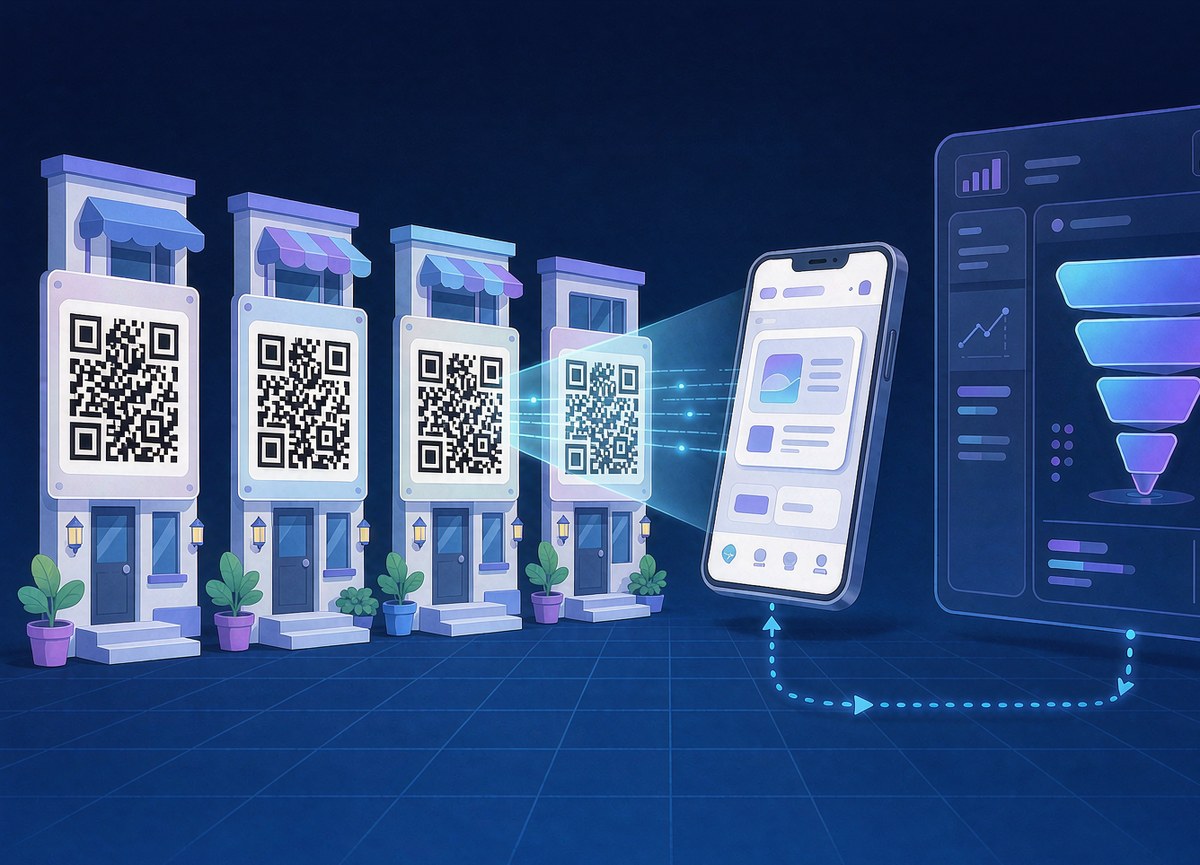
带参数的小程序码把「入口」变成了「渠道」:每张码的 scene 里埋上门店号和渠道号,扫码进入落地页后把参数解析出来上报,后台就能按维度拆数据。一张码对应一个触点,桌贴一个码、外卖卡一个码、电梯海报一个码,甚至同一家店在不同时期投放的物料也可以用不同的渠道号区分。运营拿着这张归因表去谈投放预算,比拍脑袋有说服力得多。
对开发者来说,这件事的技术链条并不长,但每一环都有坑:
flowchart LR
    A[运营侧准备门店与渠道清单] --> B[云函数批量调 getUnlimited]
    B --> C[图片写入云存储拿 fileID]
    C --> D[物料平台下载图片送去印刷]
    D --> E[用户扫码打开小程序]
    E --> F[onLoad 解析 scene 参数]
    F --> G[落地页按 scene 分流]
    G --> H[埋点上报进渠道归因表]
整条链路里,真正容易翻车的是两处:access_token 的中控管理,以及 scene 参数的字符限制与编码。前者决定了批量生成能不能稳定跑起来,后者决定了扫码进来的参数是不是你要的那串。下面按实际开发顺序拆开讲。
三种生成接口的能力边界
微信开放接口里有三个能生成小程序码的 API,很多团队踩坑的第一步就是选错了接口。三者的差异用表格对齐最直观:
| 接口 | 数量限制 | scene 支持 | path 参数 | 适用场景 |
|---|---|---|---|---|
| wxacode.createQRCode | 与 get 共享 10 万张上限 | 不支持 | 支持,长度上限 128 字符 | 少量固定入口,如官网跳转 |
| wxacode.get | 与 createQRCode 共享 10 万张上限 | 不支持 | 支持,长度上限 128 字符 | 数量可控的固定页面入口 |
| wxacode.getUnlimited | 暂无数量限制 | 支持,32 个可见字符 | 不直接支持,由 scene 携带 | 一店一码、一活动一码的批量场景 |
三个关键差异需要展开说。第一是数量:createQRCode 和 get 两个接口共享 10 万张的总上限,而且这个额度是消耗性的,删掉了也不返还。做连锁渠道码动辄几万张起,10 万张的上限根本不经花;getUnlimited 在小程序发布后数量暂无限制,这是它成为批量场景首选的直接原因。第二是参数形态:前两个接口把落地路径直接写进 path,最长 128 字符,够用但不能动态分流;getUnlimited 改用 scene 传参,小程序端在 onLoad 里解析后再决定跳哪个页面,灵活性高一整个量级。第三是前置条件:getUnlimited 要求小程序已经发布线上版本,开发阶段想调试就得靠 check_path 和 env_version 两个参数配合,这一点后面坑位清单里细说。
选型结论可以加粗记下:批量渠道码用 getUnlimited,固定少量入口才考虑另外两个。
机制剖析:access_token 中控为什么是批量生成的命门
这一节是整件事的原理核心,也是我见过最多团队栽跟头的地方。要理解为什么 token 会成为命门,得先看微信的机制设计:调用 getUnlimited 前必须先拿 access_token,token 由 appid 加 appsecret 换取,有效期 7200 秒,同一 appid 下同一时刻只认一份有效 token。这个约束是重点——新 token 生成后,旧 token 会有一个约 5 分钟的宽限窗口,之后彻底失效。
单台机器刷 token 没问题,问题出在多环境。典型的事故链是这样的:云函数环境定时任务每小时刷一次 token,公司内网的营销后台也在自己刷,第三方短信平台还存了一份长期 token。三方各自刷新,谁刷新谁的 token 生效,另外两边的 token 在 5 分钟后被顶掉。表现出来的症状是「生成小程序码时好时坏」,抓日志会看到 40001 invalid credential 或者 40001 token 已失效,随机出现、无法复现。根因只有一个:token 的获取权没有收拢,多方互相覆盖。
解法是把 access_token 做成中控服务:全网只允许一个角色向微信请求新 token,其他所有调用方都从中控读。中控内部再加两层保险——提前刷新(比如剩余有效期低于 300 秒就主动换新,避免临界点请求)和分布式锁(避免中控自身多实例并发刷新)。整个协作过程用时序图描述:
sequenceDiagram
    participant CF as 云函数A
    participant CS as token中控服务
    participant WX as 微信接口
    CF->>CS: 请求 access_token
    CS->>CS: 读缓存,剩余有效期充足
    CS-->>CF: 直接返回缓存 token
    Note over CF: 调用 getUnlimited 生成图片
    CF->>CS: 次日请求(缓存已临期)
    CS->>WX: appid+secret 换新 token
    WX-->>CS: 返回新 token 与 expires_in
    CS->>CS: 写缓存并广播失效
    CS-->>CF: 返回新 token
另外一个高频报错 47001 也和这个接口强相关:getUnlimited 要求请求体是 JSON,而 code 走的是普通 query 参数。不少教程让你把参数拼在 URL 上,body 空着或者塞了表单格式,微信解析失败就返回 47001「解析 JSON/XML 内容错误」。看到 47001 先检查请求体的 Content-Type 和序列化方式,别去怀疑 token。
云函数实现:token 缓存、批量出图、上云存储
动手写代码前交代环境:微信云开发(Node.js 16),依赖 wx-server-sdk,token 缓存放在云数据库集合 sys_access_token 里,用文档模拟中控存储。appsecret 存在云函数的环境变量里,永远不要写进代码仓库。完整实现分三块:token 中控读取、单张码生成、批量入口。
// 云函数 generateWxacode/index.js
// 运行环境:微信云开发 Node.js 16,需在 package.json 中声明 wx-server-sdk 依赖
// 环境变量:WX_APPID、WX_SECRET 由云开发控制台配置,代码中只读不存
const cloud = require('wx-server-sdk')
// https 是 Node 原生模块,云函数里直接用,无需额外安装
const https = require('https')
// DYNAMIC_CURRENT_ENV 让云函数自动使用当前环境,多环境部署不会串库
cloud.init({ env: cloud.DYNAMIC_CURRENT_ENV })

const db = cloud.database()
// 集合需要提前在云开发控制台建好,权限设为仅创建者可读写
const TOKEN_COLL = 'sys_access_token'
// 提前 300 秒刷新:避开 7200 秒有效期的临界点,防止请求打到已过期的 token
const EXPIRE_BUFFER = 300

// 分布式锁:多实例并发刷新时,只放一个实例去请求微信
// 锁的载体也是集合里的一篇文档,靠 _id 不重复实现互斥
async function acquireLock(key) {
  // add 在 _id 冲突时抛错,这正是我们要的互斥信号
  try {
    // 利用 _id 不可重复的特性做抢占,插入成功即持锁
    await db.collection(TOKEN_COLL).add({ data: { _id: key, ts: Date.now() } })
    return true
  } catch (e) {
    // _id 冲突说明锁已被持有,返回 false 让调用方走等待分支
    return false
  }
}

async function getAccessToken() {
  // 第一步:读缓存,剩余有效期大于缓冲期就直接复用
  // doc 不存在时 get 会抛错,用 catch 归一化成 null 再判断
  const cached = await db.collection(TOKEN_COLL).doc('wx_token')
    .get().catch(() => null)
  if (cached && cached.data && cached.data.expire_at > Date.now() + EXPIRE_BUFFER * 1000) {
    return cached.data.token
  }
  // 第二步:抢锁,抢到的实例负责换新 token
  // set 与 add 的区别:set 会对已存在文档做覆盖,这里复用它写回缓存
  const locked = await acquireLock('lock_wx_token')
  if (locked) {
    const fresh = await requestNewToken()
    // expire_at 用本机时间加有效期计算,比存剩余秒数更直观
    await db.collection(TOKEN_COLL).doc('wx_token').set({ data: {
      token: fresh.access_token,
      expire_at: Date.now() + fresh.expires_in * 1000
    }})
    // 用完锁立即释放,避免下一次刷新被自己的陈旧锁挡住
    await db.collection(TOKEN_COLL).doc('lock_wx_token').remove().catch(() => {})
    return fresh.access_token
  }
  // 第三步:没抢到锁就轮询等持锁者写回缓存,最多等 5 秒
  // 间隔 500 毫秒取自实测:token 接口平均响应在 300 毫秒上下
  for (let i = 0; i < 10; i++) {
    await new Promise(r => setTimeout(r, 500))
    const again = await db.collection(TOKEN_COLL).doc('wx_token')
      .get().catch(() => null)
    if (again && again.data && again.data.expire_at > Date.now() + EXPIRE_BUFFER * 1000) {
      return again.data.token
    }
  }
  // 走到这里说明中控异常,抛错让上层告警,绝不能用脏 token 硬调
  throw new Error('TOKEN_WAIT_TIMEOUT')
}

// 向微信换新 token;appsecret 从环境变量读,避免硬编码进仓库
// grant_type 固定为 client_credential,小程序场景不用 OAuth 的授权码流程
function requestNewToken() {
  const url = 'https://api.weixin.qq.com/cgi-bin/token?grant_type=client_credential'
    + '&appid=' + process.env.WX_APPID
    + '&secret=' + process.env.WX_SECRET
  return new Promise((resolve, reject) => {
    // 用原生 https.get 即可,token 接口是 GET 请求,没有 body
    https.get(url, res => {
      let buf = ''
      // 微信返回 JSON,必须把所有 chunk 拼完再 parse,边收边解析会炸
      res.on('data', chunk => buf += chunk)
      res.on('end', () => {
        const data = JSON.parse(buf)
        // 出错时返回体里没有 access_token,只有 errcode 和 errmsg
        if (!data.access_token) {
          reject(new Error('TOKEN_ERR ' + data.errcode + ' ' + data.errmsg))
        } else {
          resolve(data)
        }
      })
    }).on('error', reject)
  })
}

// 生成单张小程序码;getUnlimited 的参数全部走 JSON body,query 只带 token
async function genOneCode(accessToken, opts) {
  const payload = JSON.stringify({
    // scene 是 getUnlimited 与另外两个接口最大的差异点,必传
    scene: opts.scene,
    // page 不带斜杠开头,写 pages/xxx/xxx 而不是 /pages/xxx/xxx
    page: opts.page,
    // check_path 置 false 才能在未发布的体验版本上调试,上线前必须改回 true
    check_path: false,
    // release/trial/develop 三选一,开发期用 trial 对应体验版
    env_version: opts.envVersion || 'release',
    width: 430,
    // 线下物料建议不透明底色,透明底在部分印刷工艺下会糊
    is_hyaline: false
  })
  const url = 'https://api.weixin.qq.com/wxa/getwxacodeunlimit?access_token=' + accessToken
  const result = await postBuffer(url, payload)
  // 微信出错时返回 JSON,成功时返回图片二进制,靠 content-type 区分
  if (result.isJson) {
    // 40001 说明 token 失效,抛给上层触发一次整体刷新重试
    throw new Error('GETUNLIMITED_ERR ' + result.json.errcode + ' ' + result.json.errmsg)
  }
  return result.raw
}

// 通用二进制 POST:getUnlimited 成功时响应是图片流,必须按 buffer 接
// axios 这类库会尝试按文本解析,遇到二进制直接乱码,所以用原生 https
function postBuffer(url, body) {
  return new Promise((resolve, reject) => {
    const req = https.request(url, {
      method: 'POST',
      // Content-Type 必须是 JSON,表单编码会直接吃 47001
      headers: { 'Content-Type': 'application/json' }
    }, res => {
      const chunks = []
      // 图片流按 chunk 收集,最后 concat 成完整 Buffer
      res.on('data', c => chunks.push(c))
      res.on('end', () => {
        const raw = Buffer.concat(chunks)
        const type = res.headers['content-type'] || ''
        // JSON 响应即错误,解析出来给上层判断重试策略
        if (type.includes('json')) {
          resolve({ isJson: true, json: JSON.parse(raw.toString()) })
        } else {
          resolve({ isJson: false, raw })
        }
      })
    })
    req.on('error', reject)
    // write 与 end 分开写,body 较大时分块更稳
    req.write(body)
    req.end()
  })
}

// 上传云存储,返回 fileID;小程序端 image 组件可以直接渲染 fileID
// 云路径带业务前缀,控制台里排查和授权管理都更省事
async function uploadToCloud(buf, fileName) {
  const res = await cloud.uploadFile({
    // 按门店号与渠道号命名,运营在控制台按文件名就能检索
    cloudPath: 'wxacode/' + fileName,
    fileContent: buf
  })
  return res.fileID
}

// 批量入口:一次传入整个门店清单,逐个生成并收集结果
// 清单一般由运营平台先写进数据库,再由定时任务分批调用本函数
exports.main = async (event) => {
  // event.stores 形如 [{ storeId: 'S001', channel: 'flyer-0305' }, ...]
  const token = await getAccessToken()
  const results = []
  for (const item of event.stores) {
    // scene 自定义格式:s=门店号&c=渠道号,实测 20 字符左右,32 上限内留足余量
    const scene = 's=' + item.storeId + '&c=' + item.channel
    try {
      const imgBuf = await genOneCode(token, {
        scene: scene,
        page: 'pages/store/index',
        envVersion: event.envVersion
      })
      const fileID = await uploadToCloud(imgBuf, item.storeId + '_' + item.channel + '.png')
      results.push({ storeId: item.storeId, fileID: fileID, ok: true })
    } catch (e) {
      // 单张失败不中断整批,错误写入结果由调用方决定是否重跑
      results.push({ storeId: item.storeId, ok: false, err: e.message })
    }
  }
  return results
}
生产环境建议再补一层针对 40001 的自动重试:捕获到 40001 时删掉缓存里的 token 文档重新走一次 getAccessToken,重试一次即可,两次都失败就该告警了。云函数冷启动加上网络往返,三百张码跑完大约在两分钟量级,完全够运营排期使用。
scene 参数的 32 字符红线与编码坑
getUnlimited 的 scene 官方限制是 32 个可见字符,支持数字、大小写英文以及部分特殊字符(!#$&'()*+,/:;=?@-._~ 这一类)。这个限制看着宽松,实际有三处容易翻车。
第一处是长度。别把 scene 当 URL 用,塞满了 32 字符遇到后续加渠道维度就没地方了。设计参数格式时按 20 字符预算来,比如上面代码里 s=S001&c=flyer-0305 只有 20 字符,给未来留出扩展空间。超长微信侧会直接报 41030 之类的错误码或者静默截断,排查起来很费时间。
第二处是字符集。中文不允许出现在 scene 里,品牌名、活动名想塞进去的一律先转成编号。还有两个容易忽略的细节:scene 值不能以 & 开头,开头就带的分隔符会让小程序端解析出空 key;参数值里避免再出现 &,如果要传多个键值对就用规范的 k=v&k2=v2 结构,别自造分隔符。
第三处是编码。微信传给小程序端的 scene 是经过 encodeURIComponent 编码的字符串,= 会变成 %3D,& 会变成 %26。很多教程的解析代码直接 split('&'),结果拿到一堆以 %3D 结尾的 key,怎么都对不上。正确顺序是先 decodeURIComponent 再解析,下一节的端上代码里会写清楚。
小程序端:onLoad 解析 scene 与埋点上报
生成端搞定后,用户扫码进入的落地页要做两件事:解析 scene 分流,上报埋点进归因表。直接看落地页代码:
// pages/store/index.js
// 扫码进入时 options.scene 是 encodeURIComponent 编码过的场景值字符串
Page({
  // onLoad 的 options 里除了 scene 还可能有普通页面参数,扫码入口以 scene 为准
  onLoad(options) {
    // scene 与普通页面参数可能同时存在,扫码场景以 scene 为准
    let scene = ''
    if (options && options.scene) {
      // 不解码直接 split 是最常见的事故,日志里会看到 s%3DS001 这种 key
      scene = decodeURIComponent(options.scene)
    }
    // 解析成键值对:s=S001&c=flyer-0305 变成 { s: 'S001', c: 'flyer-0305' }
    // 手写 split 比 URLSearchParams 更可控,也避免兼容性差异
    const params = {}
    scene.split('&').forEach(pair => {
      // 空段直接跳过,防止 scene 尾部多余的 & 产生空 key
      if (!pair) return
      const idx = pair.indexOf('=')
      // 只在第一个 = 处切分,避免参数值内部再出现 = 时被切碎
      if (idx > -1) {
        params[pair.slice(0, idx)] = pair.slice(idx + 1)
      }
    })
    // 没带 scene 的进入(搜索、分享卡片等)归为自然流量
    this.setData({
      storeId: params.s || 'DEFAULT',
      channel: params.c || 'organic'
    })
    // 参数合法即上报,转化行为由后续事件单独定义
    // setData 后页面才感知到门店号,分流请求也依赖这两个值
    // 埋点在上报前先做本地兜底,弱网下可随下次启动补传
    this.reportEnter(params)
  },
  reportEnter(params) {
    // 事件需先在小程序管理台「统计-自定义分析」里配置后才能收到数据
    // 上报失败不阻塞页面流程,微信侧会自行做批量与重试
    // 事件名与参数名一旦上线不要随意改动,历史数据会断档
    wx.reportEvent('store_enter', {
      // 门店号用于按店聚合,渠道号用于按物料聚合
      store_id: params.s || 'DEFAULT',
      channel: params.c || 'organic',
      // 记录进入时间便于和线下投放时段做交叉分析
      enter_ts: Date.now()
    })
  }
})
分流逻辑放在 onLoad 拿到 params 之后:params.s 有值就请求对应门店数据并展示门店首页,没有就按普通用户走默认路径。归因表的后端设计也不复杂,一张宽表按天聚合就够用,核心维度是日期、门店号、渠道号、扫码进入次数、注册转化次数。上线 30 天后从真实项目里拆出来的对照数据大致是这个量级(数据已脱敏改写):
| 渠道码类型 | 扫码进入次数 | 注册转化数 | 转化率 | 环比上周 |
|---|---|---|---|---|
| 门店桌贴码 | 18,640 | 1,932 | 10.4% | +2.1% |
| 外卖卡片码 | 9,215 | 1,289 | 14.0% | +5.6% |
| 社区地推码 | 6,087 | 712 | 11.7% | -1.3% |
| 电梯海报码 | 3,450 | 221 | 6.4% | +0.8% |
| 自然流量对照 | — | — | — | 基线 |
这组数据最反直觉的是外卖卡片码:曝光量不到桌贴码的一半,转化率却是全场最高——外卖场景用户已经在消费,扫码领券的动作路径短。电梯海报码曝光大转化低,运营据此把下期预算挪给了外卖卡。没有 scene 参数,这张表就无从谈起。
坑位清单:上线前逐条核对
把团队实际踩过的坑整理成清单,逐条过一遍再上线:
- scene 不能以 & 开头,开头就带的分隔符会解析出空 key,参数直接丢。
- scene 不支持中文,活动名、门店名一律换成编号,映射关系存自己的数据库。
- getUnlimited 数量不限的前提是小程序已发布线上版本;未发布调试要 check_path 设 false 且 env_version 用 trial 或 develop,上线时改回。
- width 取值范围 280 到 1280,印刷物料建议 860 以上再交给设计师放大,小图拉伸会糊。
- line_color 用十六进制格式如 #FF0000 的对象写法传,写成字符串颜色名会报参数错误。
- 响应是图片二进制还是 JSON 错误体,靠 content-type 判断,不要按状态码判断。
- getUnlimited 拿到的图片内容不含有效期概念,但不要用外链缓存图片 URL,落云存储最稳。
- 云函数里 token 文档的并发写要靠 _id 不可重复的特性加锁,直接 set 会在多实例下产生竞态。
- 桌贴等强光环境物料用 is_hyaline false 不透明底,透明底在覆膜工艺下识别率明显下降。
还有一个认知层面的误区要澄清:很多人以为场景值 scene 只在扫码进入时有意义,其实从「小程序码」这个入口体系看,scene 的价值在于把线下流量数字化。线下物料本来是完全黑盒的投放,一个 32 字符的参数让它获得了和线上广告同等的归因能力。这也是为什么这两年小程序码加门店私域的组合被越来越多连锁品牌采用——码是入口,scene 是身份,归因表是运营决策的依据。整套东西用云函数一天就能搭起来,技术门槛不高,缺的往往只是上线前把坑位清单过一遍的耐心。
实现细节上如果遇到别的报错码,欢迎在评论区贴原始日志一起排查。
参考与延伸
- wxacode.getUnlimited 接口文档:scene 限制、请求参数与错误码的官方说明。
- 场景值与获取方式:onLoad 中 scene 参数的编码规则与解析示例。
微信小程序,小程序码,wxacode,场景值,Node.js,云函数,渠道运营