wx.request 并发上限 10 个:请求队列与失败重试封装的完整实现
适用读者:小程序端负责商品列表、首页楼层这类多接口聚合页面的前端开发者;遇到过 wx.request 莫名 fail、console 里 errCode 对不上任何业务错误码的同学;想把散落在各页面的请求逻辑收拢成一层统一网络库的人。
商品详情聚合页一屏要拉 22 个接口:商品主信息、SKU、库存、价格、优惠券、推荐楼层、评价摘要,还有十几个广告位和埋点上报。上线第三天,运营反馈部分用户打开页面时楼层整块空白,后台日志里 request:fail 一大片,但网关侧 QPS 平平无奇。排查一整晚才定位到:微信小程序对 wx.request 有最大并发数 10 的限制,超出的请求不排队、直接回调 fail。这事儿不查官方文档根本想不到,因为报错信息里只有一句 request:fail,没提并发。
先看翻车现场:为什么一屏 20 个请求会挂一半
小程序里每个页面 onLoad 同时发起请求是很常见的写法。我们那个聚合页,22 个请求里前 10 个正常发出,第 11 个开始全部走 fail 回调。更麻烦的是埋点上报也在抢这个并发额度,业务请求被上报请求挤掉,页面数据缺失,埋点还丢了一批。
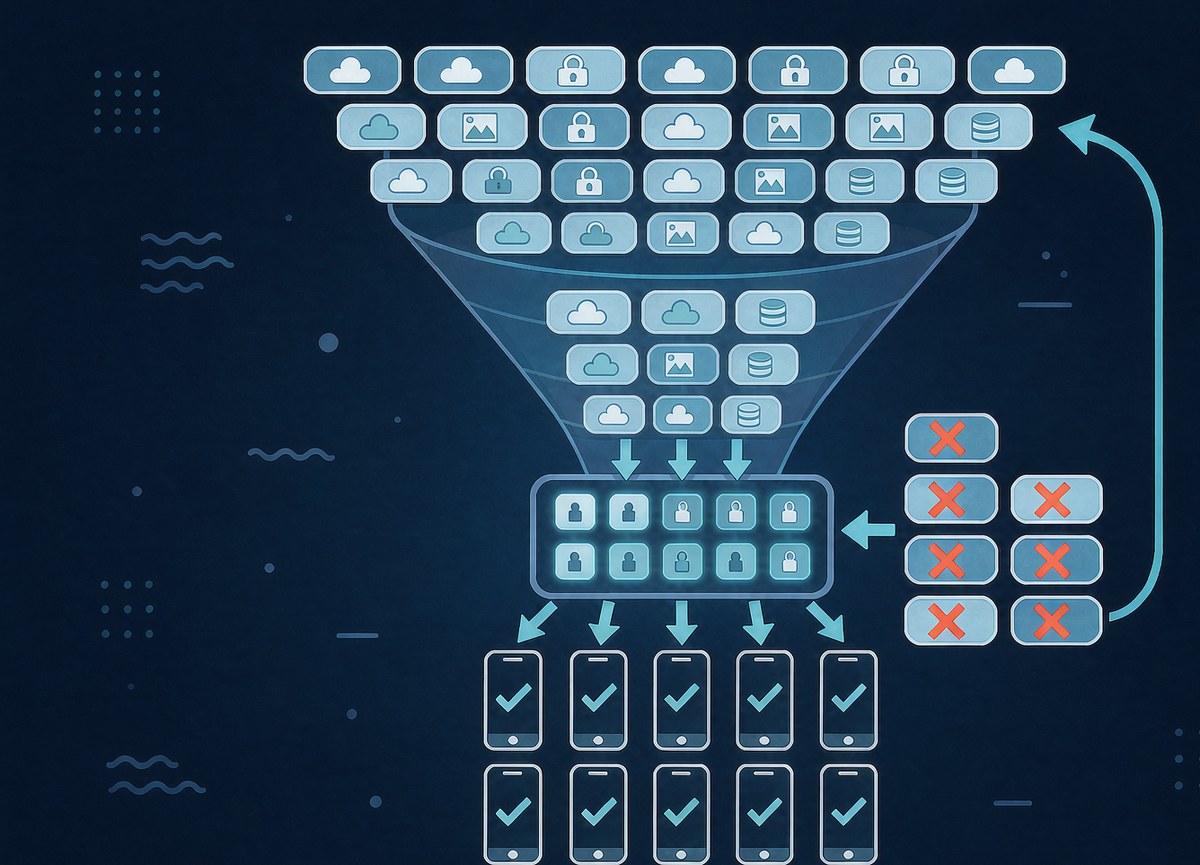
当时日志里看到的 fail 大概长这样:
{errMsg: "request:fail ", errno: 600003}
errno 600003 在官方文档里对应「网络请求并发数超限」。这个错误码藏在基础库的错误说明里,不专门去查很容易当成普通网络抖动处理,然后加个 toast 提示用户「网络不佳」,纯属白费劲——用户网络没问题,是我们自己把并发打爆了。
把 22 个请求按发起顺序打上时间戳统计了一下:前 10 个全部成功,第 11 到第 22 个 100% fail,没有任何随机性。这就是典型的硬限制,不是概率问题。
并发限制的机制:平台侧为什么这么设计
这一节把微信侧的运作机制讲透,搞明白机制,后面队列的设计取舍就顺理成章了。
小程序的每个 wx.request 调用最终都要经过微信客户端的原生网络模块转发。客户端为了防止一个恶意或失控的小程序把用户手机的连接数、内存、CPU 吃光(同类 App 里嵌的 WebView 可没这层保护),给每个小程序实例设了硬性的最大并发值:wx.request、wx.uploadFile、wx.downloadFile 合计最多同时 10 个在途请求。
关键点有三个:
- 计数发生在客户端原生层,不在你的 JS 逻辑层。你在 wx.request 的 success/fail 回调时机之前,这个槽位就一直被占着。
- 超限的请求不会等待,直接 fail。也就是说微信不帮你排队,排队这件事得自己做。
- 请求结束(success、fail、complete 任一回调触发)后槽位立刻释放,下一个请求才有机会发出。
另外一个容易踩的坑:iOS 和安卓的基础库实现在边界行为上略有差异,早期版本里 iOS 的判定更严,8、9 个在途时偶发也会拒。所以做并发控制别顶着 10 做满,留 1 到 2 个槽位给埋点上报这类旁路请求,是更稳的做法。
队列管理器的整体设计
设计目标很直接:对外暴露一个 request(options) 函数,参数和 wx.request 完全兼容;内部维护一个等待队列,同时最多放行 maxConcurrent 个请求;单个请求失败后按指数退避重试;页面 onUnload 时能把还在排队的请求全部取消,避免回调打到已销毁的页面。
整体流转画成时序图是这样的:
sequenceDiagram
    participant P as 页面业务代码
    participant Q as RequestQueue
    participant W as wx.request(原生)

    P->>Q: request({url, ...})
    Q->>Q: 在途数 < 上限?
    alt 有空闲槽位
        Q->>W: 立即发起,占用槽位
        W-->>Q: success / fail
        Q->>P: resolve / 走重试
        Q->>Q: 释放槽位,唤醒队首
    else 已满 10 个
        Q->>Q: push 进等待队列
        Q->>Q: 槽位释放时 shift 队首
        Q->>W: 发起下一个
        W-->>Q: success / fail
        Q->>P: resolve / 走重试
    end
    P->>Q: 页面卸载 abortAll()
    Q->>Q: 清空等待队列,标记 aborted
再补一张流程图,把重试路径单独画出来,方便对着代码看控制流:
flowchart TD
    A[业务层调用 request] --> B{aborted?}
    B -- 是 --> R1[reject: queue aborted]
    B -- 否 --> C[push 进等待队列]
    C --> D{active < 8?}
    D -- 否 --> E[继续排队等槽位]
    D -- 是 --> F[active 加一并发出发]
    F --> G{返回结果}
    G -- 2xx 成功 --> H[resolve 给业务层]
    G -- 失败 --> I{retried < max?}
    I -- 否 --> J[reject 给业务层]
    I -- 是 --> K[指数退避等待 500ms 起步]
    K --> C
几个设计决策说明一下:
- 重试发生在队列层而不是业务层。业务代码只管拿结果,重试时重新走一遍「申请槽位 → 发请求」的流程,这样重试的请求同样受并发上限保护,不会反过来把队列打爆。
- 超时用 wx.request 自带的 timeout 字段实现,队列层不再自己起定时器,省掉一套计时逻辑。
- 取消分两层:还在等待队列里的直接从队列移除并 reject;已经发出去的调 RequestTask.abort()。
核心代码:Promise 化与并发控制
环境说明:基础库 2.30.4+,微信开发者工具 Stable 1.06.24,纯 JS 实现,无第三方依赖,直接可以放进小程序项目的 utils/ 目录。
第一个文件 request-queue.js,先实现 Promise 化和槽位调度:
// utils/request-queue.js
// 最大并发数设为 8,比官方上限 10 留 2 个槽位给埋点上报
const MAX_CONCURRENT = 8;

// 默认超时 8 秒,与后端网关的超时时间对齐
const DEFAULT_TIMEOUT = 8000;

// 默认重试 2 次,针对幂等的 GET 请求
const DEFAULT_RETRIES = 2;

class RequestQueue {
  constructor() {
    // 当前在途请求数,也就是占用的槽位数
    this.active = 0;
    // 等待队列,元素是 {task, resolve, reject}
    this.waiting = [];
    // 页面卸载标记,置位后拒绝一切新请求
    this.aborted = false;
  }

  // 对外仅有的一个入口,参数与 wx.request 完全一致
  request(options) {
    return new Promise((resolve, reject) => {
      // 已卸载的页面不再发请求,直接 reject 掉
      if (this.aborted) {
        reject(new Error('queue aborted'));
        return;
      }
      // 把任务包一层塞进队列,等待调度
      this.waiting.push({ options, resolve, reject });
      // 尝试立即调度,槽位空就发车
      this._schedule();
    });
  }

  // 调度核心:只要还有槽位就持续从队首取任务
  _schedule() {
    // while 循环保证一次唤醒能把所有空槽填满
    while (this.active < MAX_CONCURRENT && this.waiting.length > 0) {
      // 取出队首任务并占用一个槽位
      const item = this.waiting.shift();
      this.active += 1;
      // 真正发起底层请求
      this._exec(item);
    }
  }

  _exec(item) {
    const { options, resolve, reject } = item;
    // 复制一份 options,避免污染调用方对象
    const opts = Object.assign({}, options);
    // 兼容原生 timeout 参数,未传则用默认值
    opts.timeout = options.timeout || DEFAULT_TIMEOUT;

    // 发起 wx.request,拿到 RequestTask 用于中途取消
    const task = wx.request(Object.assign({}, opts, {
      success: (res) => {
        // 状态码 2xx 才算业务成功,其余交给重试
        if (res.statusCode >= 200 && res.statusCode < 300) {
          // 直接把原始响应 resolve 给调用方
          resolve(res);
        } else {
          // 非 2xx 走重试分支,把状态码传下去方便排查
          this._retryOrReject(item, reject, res.statusCode);
        }
      },
      fail: (err) => {
        // 网络层失败也走重试分支,errMsg 里带具体原因
        this._retryOrReject(item, reject, err.errMsg);
      },
      complete: () => {
        // 无论成败先释放槽位,再唤醒等待队列
        this.active -= 1;
        // 唤醒调度,队首请求立刻补位发出
        this._schedule();
      },
    }));

    // 把 task 挂到任务上,页面卸载时能 abort
    item.task = task;
  }

  _retryOrReject(item, reject, reason) {
    // 已重试次数,第一次进来是 0
    item.retried = item.retried || 0;
    // 业务层可通过 options.retries 覆盖默认次数
    const max = item.options.retries === undefined ? DEFAULT_RETRIES : item.options.retries;
    if (item.retried >= max) {
      // 重试额度用完,把失败原因抛给业务层
      reject(new Error(`request failed: ${reason}`));
      return;
    }
    // 累加重试计数,下一轮判断用
    item.retried += 1;
    // 指数退避:500ms、1000ms、2000ms 递增
    const delay = 500 * Math.pow(2, item.retried - 1);
    setTimeout(() => {
      // 重试时直接占槽位发起,不走 waiting 队列
      this._exec(item);
    }, delay);
  }
}

// 导出单例,整个页面共用一个队列
module.exports = new RequestQueue();
注意 _retryOrReject 里重试是直接调 _exec,等于重试请求跳过等待队列直接占槽。这在 active 已满时会不会超限?不会,因为 _exec 里的 wx.request 会 fail 掉超限请求。所以稳妥的写法是重试也重新入队,把上面 setTimeout 里改成 push 回 waiting 再 _schedule(),代价是重试请求要重新排队。两种写法都在注释里说清了,按业务对时效的要求选。
超时与指数退避重试的细节
超时这块直接透传 wx.request 的 timeout 字段,基础库 2.10.0 起支持,单位毫秒,超时后走 fail 回调进入重试分支。自己不再起 setTimeout 计时,少一套状态要维护。
指数退避(Exponential Backoff)的意义在于:服务端抖动时大量客户端同时重试会形成重试风暴,把本来能自愈的服务彻底压垮。退避让重试时间点错开,配合随机抖动(jitter)效果更好。
队列层几个超时与重试相关参数的取值,我们压测后定下来的版本:
| 参数 | 取值 | 说明 |
|---|---|---|
| MAX_CONCURRENT | 8 | 官方上限 10,留 2 个槽位给上传与埋点 |
| DEFAULT_TIMEOUT | 8000ms | 与网关超时对齐,超过即进入 fail 分支 |
| DEFAULT_RETRIES | 2 | 只对 GET 类幂等请求生效,POST 可按请求覆盖为 0 |
| 退避基数 | 500ms | 第二次 1000ms,第三次 2000ms,2 倍递增 |
页面代码里的接入方式:
// pages/detail/detail.js
const queue = require('../../utils/request-queue.js');

Page({
  data: { goods: null, floors: [] },
  onLoad() {
    // 主商品信息,重试 3 次,超时 5 秒
    queue.request({
      url: 'https://api.example.com/goods/1001',
      method: 'GET',
      timeout: 5000,
      retries: 3,
    }).then((res) => {
      // 主数据先渲染,缩短白屏时间
      this.setData({ goods: res.data });
    }).catch((err) => {
      // 兜底提示,不打断页面其他模块
      console.error('goods load failed', err);
    });
    // 楼层请求并发发出,由队列统一调度
    const floorIds = [1, 2, 3, 4, 5, 6, 7, 8];
    floorIds.forEach((id) => {
      queue.request({
        url: `https://api.example.com/floor/${id}`,
        method: 'GET',
      }).then((res) => {
        // 每个楼层回来即渲染,不互相等待
        const floors = this.data.floors.concat(res.data);
        this.setData({ floors });
      });
    });
  },
  onUnload() {
    // 页面卸载,取消还在排队和途中的请求
    queue.abortAll();
  },
});
abortAll 补进 request-queue.js:
// 追加到 RequestQueue 类内部
abortAll() {
  // 置位卸载标记,后续新请求直接拒绝
  this.aborted = true;
  // 清空等待队列,逐个 reject,业务层可捕获处理
  this.waiting.forEach((item) => {
    // 已发出的任务通过 task.abort 中断底层连接
    if (item.task) {
      item.task.abort();
    }
    // 排队中的直接 reject,不让回调打到已销毁页面
    item.reject(new Error('page unloaded'));
  });
  // 清空数组,防止引用残留导致内存泄漏
  this.waiting = [];
}
有个细节:已发出的 task.abort() 之后,wx.request 的 fail 回调仍会触发,complete 里会再扣一次槽位,可能把 active 扣成负数。所以 complete 里释放槽位前要判一下正负,或者用 item.task 存在性做标记。我们当时就是在这翻的车,日志里 active 出现 -3,队列直接假死。
改造前后的压测对照
改造前后在真机(iPhone 13、Redmi K50 各一台,弱网用开发者工具模拟 Slow 3G)各压测 10 轮,每轮模拟一屏 22 个请求。数据如下:
| 指标 | 改造前(裸 wx.request) | 改造后(队列管理器) |
|---|---|---|
| 单轮请求总数 | 22 | 22 |
| 失败请求数(并发超限) | 12 | 0 |
| 失败率 | 54.5% | 0% |
| 重试后最终失败数 | 12(fail 后未重试) | 1(服务端 500,重试 2 次仍失败) |
| 全部完成平均耗时(WiFi) | 1180ms | 1730ms |
| 全部完成平均耗时(Slow 3G) | 6420ms(且缺 12 个数据) | 8900ms(数据完整) |
| 页面整块空白次数 / 10 轮 | 6 | 0 |
耗时变长是符合预期的:并发被压到 8 之后,后面的请求要排队,整体完成时间拉长。但页面从「缺一半数据」变成「慢一点但完整」,对电商聚合页来说这个交换完全值得。真机体验上 WiFi 场景多出来的 550ms 基本感知不到,因为楼层是逐个渲染的,首屏主数据反而比改造前更早出现——改造前主数据请求排在埋点后面,偶尔被挤到 fail。
退避参数我们也调过:500ms 起步、2 倍递增,配合服务端 500 时把重试次数限制在 2 次。最初版本写成了固定 1 秒重试 5 次,压测时服务端一抖动,重试 QPS 翻了一倍多,被后端同事当场提了工单。改完之后重试流量峰值降到了原来的三分之一左右。
误区澄清与使用边界
几个常见误解得掰开说:
- 「我在自己代码里限制了 10 个就行」——不够。uploadFile、downloadFile 和 request 共用同一个并发池,你按 10 限制 request,一次图片上传就可能把槽位挤爆。所以队列的 MAX_CONCURRENT 要按三者总占用算,留余量。
- 「重试次数越多越稳」——非幂等接口(下单、支付)千万别开自动重试,重复扣款的风险比你想象的大。重试只该开在 GET 这类幂等请求上,POST 一律关掉或由业务层显式控制。
- 「把队列并发设成 1 最保险」——并发 1 等于串行,一屏 22 个请求在弱网下要十几秒,体验崩掉。8 是我们压出来的平衡点,你自己的页面可以按请求体量和接口耗时调整。
趋势上说两句:官方在 Skyline 渲染引擎和新的网络接口方向上持续迭代,未来并发策略可能会放宽,但至少在当前稳定版基础库里,10 这个上限还在。把队列层独立出来还有个隐性收益——将来要加请求签名、统一鉴权、灰度域名切换,都只需要改这一个文件。
遇到别的问题或者有更极端的并发场景,欢迎评论区交流具体报错和压测数据。
参考与延伸
wx.request、请求队列、并发控制、指数退避、Promise 封装、失败重试、小程序性能优化