连锁品牌组织树的结构化表达:subOrganization 与 parentOrganization 落地方案
适用读者:负责多门店连锁品牌的站点工程师、做本地服务类目实体优化的技术 SEO/生成式引擎优化(Generative Engine Optimization, GEO)从业者、给品牌官网做结构化数据改造的架构同学。
上个月帮一个全国 60 多家门店的家政连锁品牌做诊断,问 AI 搜索「XX 家政上海门店在哪」,它把浦东店答成一家叫「XX到家」的独立公司,把北京店挂到另一个品牌名下——三家门店、三个「实体」,没有一个被归到总部品牌下。官网代码里每家门店页都规规矩矩挂着 LocalBusiness,但页面之间没有任何组织关系声明,机器只能把每页当成孤立实体处理。这篇文章记录我们用 Schema.org 的 subOrganization 和 parentOrganization 做组织树实体建模的完整过程,改造 6 周后,AI 搜索回答中门店归属正确率从 31% 提到 78%。
先说问题出在哪
连锁品牌的典型站点结构是这样的:总部一个品牌页(/about 或者就是首页),每个区域一个子品牌或分公司页(/shanghai、/guangzhou),再往下每个门店一个详情页(/stores/pudong-01)。每个门店页各自带一段 JSON-LD:
{
  "@context": "https://schema.org",
  // 门店节点,只声明 LocalBusiness 自身的事实字段
  "@type": "LocalBusiness",
  // @id 全站不重复,fragment 固定为 #business
  // URL 部分必须返回 200,否则边解析会断
  "@id": "https://example.com/stores/pudong-01#business",
  "name": "XX家政(浦东店)",
  // 地址结构体,PostalAddress 是固定类型
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "浦东南路 000 号",
    "addressRegion": "上海",
    // addressCountry 用两位国家码 CN
    "addressCountry": "CN"
  },
  // 电话用 E.164 格式,带国家区号
  "telephone": "+86-21-0000-0000",
  // 营业时间,Mo-Su 表示周一到周日
  "openingHours": "Mo-Su 08:00-20:00"
}
这段代码单看没有毛病,校验工具也会给绿色通过。问题在于 60 个门店页就有 60 个互不相连的 LocalBusiness 节点,总部页的 Organization 和它们之间零引用。抓取侧(无论是传统爬虫还是 AI 引擎的内容理解管线)读到的图是断裂的:一个 Organization 节点,加 60 个孤岛节点。
实体消歧靠的不是名字相似,是图上的边。「XX家政(浦东店)」和「XX家政」在人类眼里显然是同一家,但大语言模型做实体对齐时,如果两个实体之间没有任何结构化关系边,名字相同反而可能被当成重名——尤其当门店页用了子品牌名(比如区域公司注册名和品牌名不一致)时,误判概率更高。我们诊断的那家品牌,三个区域子公司在工商注册名里带「XX」字样但不带品牌全称,AI 搜索直接把它们答成了三家不相干的公司。
GEO 语境下这个问题的代价比传统搜索大得多。传统搜索里用户看到的是 10 条蓝色链接,自己会点进官网确认;AI 搜索直接给一个答案,说错了用户就拿走了这个错误认知。门店归属错误等于把客流导给了不存在的竞品。
组织树实体建模:一张图说清楚
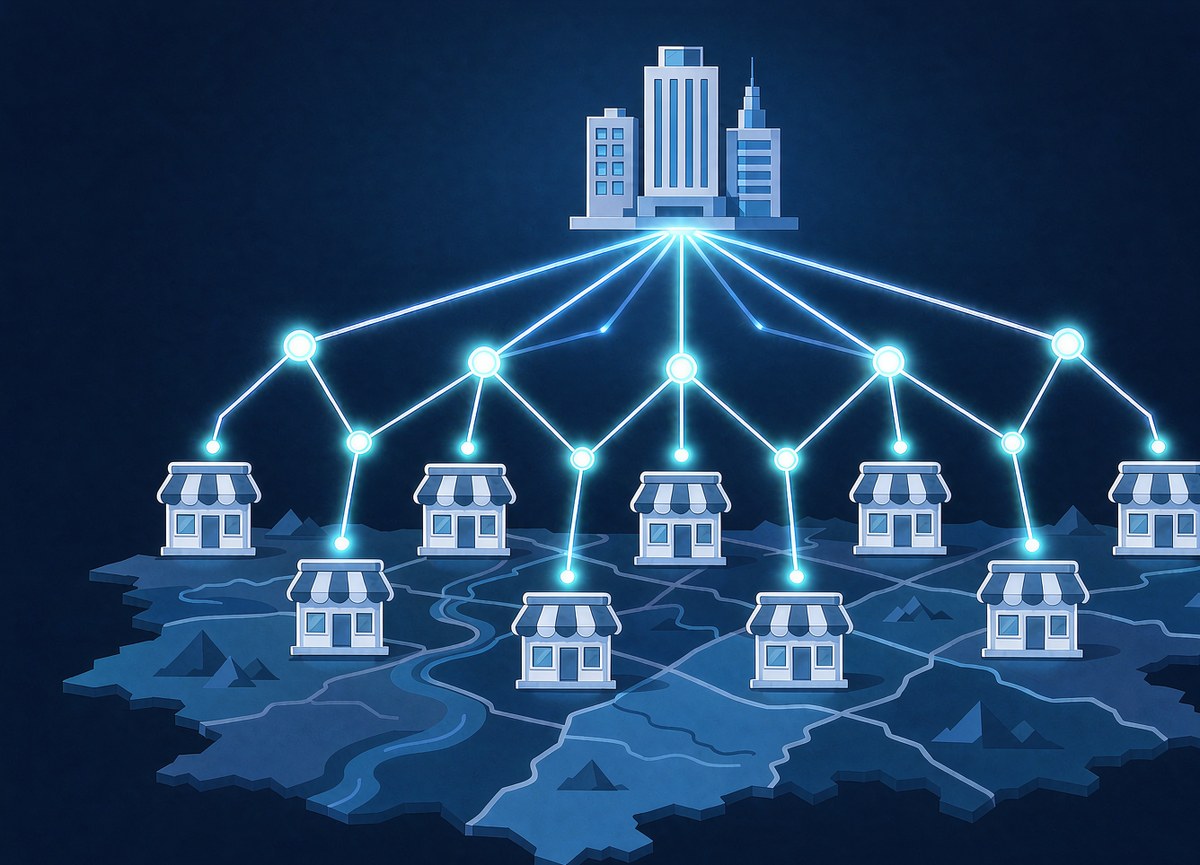
目标结构是三层:品牌总部 Organization 作为根节点,通过 subOrganization 指向区域公司(也是 Organization 类型),区域公司再指向门店 LocalBusiness。同时每层用 @id 固定实体身份,让引用可以跨页面解析。
graph TD
    // 根节点:品牌总部 Organization
    // @id 固定为站点根 + #organization
    A["Organization<br/>品牌总部<br/>@id: /#organization"] -->|subOrganization| B["Organization<br/>上海区域公司<br/>@id: /shanghai/#org"]
    // 总部到广州区域公司,同样一条 subOrganization 边
    // 有几个区域公司就画几条边,与总部页数组一致
    A -->|subOrganization| C["Organization<br/>广州区域公司<br/>@id: /guangzhou/#org"]
    // 区域公司向下一级指向门店 LocalBusiness
    B -->|subOrganization| D["LocalBusiness<br/>浦东店<br/>@id: /stores/pudong-01#business"]
    B -->|subOrganization| E["LocalBusiness<br/>静安店<br/>@id: /stores/jingan-01#business"]
    C -->|subOrganization| F["LocalBusiness<br/>天河店<br/>@id: /stores/tianhe-01#business"]
    // 虚线是反向边:门店用 parentOrganization 指回上级
    // 双向都要写,不同引擎解析方向不一致
    D -.->|parentOrganization 反向引用| B
    E -.->|parentOrganization 反向引用| B
    F -.->|parentOrganization 反向引用| C
两个方向都挂边是关键。Schema.org 里 subOrganization 和 parentOrganization 互为逆属性(inverse property),规范上写一边理论上也够,但 AI 引擎的解析器实现参差,有的只认从门店出发的 parentOrganization,有的只做自顶向下遍历。我们实测两边都写、保证一致,是最稳的做法——多几行代码,换的是不同引擎下的解析兼容性。
区域这层要不要单独建 Organization 节点?如果区域公司有独立工商注册、独立客服电话、独立经营范围,建议建;如果只是内部管理划分,可以砍掉这一层,总部直接 subOrganization 到门店。中间层每多一层,解析链路就多一次跳转,图越深引用断裂的概率越大。我们最终保留了区域层,因为那家品牌的三个区域公司都有独立 400 电话,这个信息本身对 AI 回答「上海XX家政的客服电话」有用。
@id 设计规范:不重复、稳定、可解析
@id 是整个方案的基石。实体在图上的身份完全由 @id 决定,@id 变一次,之前积累的实体关联全部作废。踩过的坑和定下来的规则:
| 规则 | 做法 | 反例 |
|---|---|---|
| 全站不重复 | 用「站点根 URL + 路径 + #fragment」 | 两个门店页 @id 都写 #business |
| 稳定不变 | 跟随门店,不跟随 URL 改版 | 门店 slug 改了 @id 跟着变 |
| 可解析 | @id 的 URL 部分能返回真实页面(200) | 指向一个 404 的虚构地址 |
| fragment 区分类型 | 同一页面多个实体用 #org、#business 区分 | 同页两个实体共用一个 @id |
第四条值得展开。门店详情页上往往同时存在两个实体:区域公司(作为上级组织出现)和门店本身。它们必须用不同 fragment,比如 https://example.com/shanghai/#org 和 https://example.com/stores/pudong-01#business。如果共用,解析器会把两个不同类型的节点合并成一个,LocalBusiness 的营业时间字段和 Organization 的 founder 字段搅在一起,图直接脏了。
另外 @id 不需要真的大写域名规范化问题——统一小写、统一 https、末尾不要多余斜杠,用一台 CI 任务每周扫一遍全站 JSON-LD,diff 出 @id 变化。我们有一次改版把 /stores/pudong-01 改成 /shanghai/pudong,@id 跟着 URL 走导致 60 个实体全部换身份证,AI 搜索里原本积累的门店归属在两周内退化回改造前的水平。教训写进了规范:URL 可以变,@id 保持旧值不变,或用 sameAs 桥接。
总部页与门店页的双向引用写法
总部页的 JSON-LD,用 @graph 把整个组织树的骨架放进去:
{
  "@context": "https://schema.org",
  // @graph 允许一页声明多个实体节点
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://example.com/#organization",
      // 品牌总部实体,组织树的根节点
      "name": "XX家政",
      "url": "https://example.com/",
      "logo": "https://example.com/logo.png",
      "foundingDate": "2015-06",
      // founder 只在总部节点声明,门店节点不要重复
      // Person 也建议给独立 @id,避免多页同名人对不上
      "founder": {
        "@type": "Person",
        "name": "Wang",
        "jobTitle": "创始人"
      },
      // subOrganization 只列直属下一级区域公司
      // 只引用 @id,不在总部页重复展开门店字段
      // 新开区域公司时在这里加一条引用即可
      "subOrganization": [
        { "@id": "https://example.com/shanghai/#org" },
        { "@id": "https://example.com/guangzhou/#org" }
      ]
    },
    {
      // 第二个节点:上海区域公司,类型仍是 Organization
      "@type": "Organization",
      "@id": "https://example.com/shanghai/#org",
      // 区域公司节点,只写身份和指向门店的边
      // fragment 固定为 #org,与门店的 #business 区分
      "name": "XX家政(上海)",
      // parentOrganization 指回总部,双向边的上行方向
      "parentOrganization": { "@id": "https://example.com/#organization" },
      // 区域 400 电话,与门店直线电话区分开
      "telephone": "+86-400-000-0000",
      // areaServed 描述服务范围,不等于经营范围
      // 粒度到城市,具体到行政区交给门店的 address
      "areaServed": [
        // City 类型,也可以换 AdministrativeArea
        { "@type": "City", "name": "上海" },
        { "@type": "City", "name": "苏州" }
      ],
      // 区域公司向下的边,指向旗下门店节点
      // 只引用 @id,字段留在各门店页自己声明
      "subOrganization": [
        { "@id": "https://example.com/stores/pudong-01#business" },
        { "@id": "https://example.com/stores/jingan-01#business" }
      ]
    }
  ]
}
门店页只放门店自己的 LocalBusiness,用 parentOrganization 指回上级,不重复粘贴整棵树:
{
  "@context": "https://schema.org",
  "@type": "LocalBusiness",
  "@id": "https://example.com/stores/pudong-01#business",
  // 门店节点,字段只描述这一家店的事实
  "name": "XX家政(浦东店)",
  // 指回区域公司,@id 必须与总部页声明严格一致
  // 大小写、末尾斜杠差一个字符边就断了
  "parentOrganization": { "@id": "https://example.com/shanghai/#org" },
  // 地址结构体,与总部页的 areaServed 粒度互补
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "浦东南路 000 号",
    "addressRegion": "上海",
    "addressCountry": "CN"
  },
  // 经纬度让「离我最近的门店」类问题可答
  "geo": {
    "@type": "GeoCoordinates",
    // 精度到小数点后五位足够门店级定位
    "latitude": 31.22,
    "longitude": 121.53
  },
  // 门店直线电话,别偷懒填总部号码
  "telephone": "+86-21-0000-0000",
  // 用 OpeningHoursSpecification 比 openingHours 字符串更结构化
  // dayOfWeek 也可以写 ["Monday-Sunday"] 简写形式
  // 跨零点营业的门店写两个时间段,别用 24:00
  "openingHoursSpecification": [{
    "@type": "OpeningHoursSpecification",
    "dayOfWeek": ["Monday","Tuesday","Wednesday","Thursday","Friday","Saturday","Sunday"],
    "opens": "08:00",
    "closes": "20:00"
  }],
  // sameAs 挂第三方平台主页,辅助实体对齐
  // 链接必须是可公开访问的真实页面
  "sameAs": [
    "https://m.example-dp.com/shop/pudong-01"
  ]
}
这种「总部放树、门店放叶」的分工是刻意的。如果把整棵树在每家门店页都复制一遍,60 个页面要维护 60 份相同的图,任何一次组织调整(新开区域、关店)都要改 60 个文件,实际执行中必然出现不一致——而不一致的图比没有图更糟,解析器遇到互相矛盾的边会把整个品牌的置信度降级。
字段配合的边界:areaServed、founder 放哪一层
几个容易被滥用的字段,边界划清楚能省很多返工。
areaServed 放区域层或门店层,不放总部层。 总部写 areaServed 等于宣告品牌服务全国,这个粒度对 AI 回答「XX家政在杭州有门店吗」没有帮助,反而可能诱导它把没有门店的城市也答成有。区域公司写服务的城市,门店写具体行政区(用 AdministrativeArea 或直接靠 address),三层各管各的粒度。我们诊断时发现原站点把 32 个城市名全堆在总部 areaServed 里,改成分层声明后,「具体城市有没有店」这类问题的回答准确率明显上来了。
founder、foundingDate 这类公司史字段只在总部节点出现。 门店节点写 founder 是语义错误——创始人不属于任何一家门店。出现一次就够,多节点重复声明同一 Person 实体而没有统一 @id,会被当成多个同名人。
telephone 各层写各层的真实号码。 总部写品牌总机,区域写 400,门店写门店直线。不要为了省事全填总部号码,AI 回答时会拿最近实体的电话作答,用户打到总机问浦东店的排班,体验就断在最后一公里。
aggregateRating 只在真实聚合口径下使用。 如果品牌做的是全平台评分聚合,挂在总部;门店分平台评分挂各自门店。把门店评分冒充品牌评分是字段级造假,被引擎识别后整个实体的可信度都会受牵连。
改造前后的数据对照
同一个品牌,改造前后各跑了一轮评估。方法是固定的 20 个问句模板(覆盖「品牌+城市有没有门店」「品牌+门店地址」「品牌和XX是不是一家」「品牌创始人是谁」四类),分别问 3 个主流 AI 搜索入口,人工核对答案里实体归属是否正确,取三轮多数。执行时间点:基线在改造前一周测,复测在第 6 周。
| 指标 | 改造前 | 改造后(第 6 周) |
|---|---|---|
| 20 个问句实体归属正确数 | 6 / 20 | 16 / 20 |
| 门店被归到同一品牌实体比例 | 31%(19/61 个门店实体) | 78%(48/61) |
| 区域公司被当成独立公司次数(60 次问答中) | 23 次 | 5 次 |
| 「创始人是谁」回答正确 | 0 / 3 个入口 | 2 / 3 个入口 |
| 品牌 Knowledge 面板出现率(自有触发测试) | 偶发 | 稳定出现 |
几个第一手的观察:
- 第 2 周开始有入口的答案里出现「XX家政(上海)」这个区域公司名,说明图被读到了;第 4 周门店归属比例过半;第 6 周趋于稳定。实体类优化生效是周级不是天级的,别指望提交 Sitemap 当晚见效。
- 没改任何页面文案,纯结构化数据改动,页面在传统搜索的排名没有可观测变化。这佐证了改动的作用域就是实体理解层。
- 有一个入口始终不认 subOrganization 方向的边,只认 parentOrganization,这就是前面强调双向写的直接证据。
- 同期给门店页补了 geo 坐标(原先缺),「离我最近的XX门店」类问题的质量提升比组织树本身还明显——两者叠加效果大于单项之和。
原理剖析:AI 引擎怎么消费这棵组织树
这一节拆机制,解释为什么这么建模有效。
AI 搜索引擎处理品牌类查询大致是三步:先从查询里抽出实体意图(「XX家政」),再从索引里召回该实体的知识条目(可能来自自家知识图谱、抓取的页面结构化数据、以及第三方数据源),最后用语言模型把这些条目编织成答案。门店归属错误通常发生在第二步:引擎为「XX家政」建立知识条目时,只有总部 Organization 的信息,门店各自为政、没有边连过来,于是被当成别的条目。
subOrganization/parentOrganization 提供的就是缺失的边。解析器读到门店页的 parentOrganization 后,会顺着 @id 去解析上级实体——前提是 @id 可解析,这就是为什么 @id 必须指向 200 的页面,且页面里真的有对应 @id 的节点(总部页 @graph 里的节点要和门店页引用的 @id 严格一致,大小写和末尾斜杠都不能差)。边解析成功后,门店的事实(地址、电话、营业时间)就会以「XX家政的属性」身份进入答案生成的候选池。
@graph 的作用是让「一页多实体」有干净的命名空间。JSON-LD 里节点之间靠 @id 互相引用,@graph 相当于把一页上的多个节点打包并允许内部互链,解析器把它展开成图。这也是为什么总部页推荐用 @graph 而不是多个 script 标签并列——后者也能解析,但 @graph 让节点关系在同一份文档里自洽,减少跨标签解析失败的边角情况。
sequenceDiagram
    // 一次品牌类查询在 AI 引擎侧的处理时序
    participant U as 用户提问
    participant E as AI 搜索引擎
    participant G as 知识图谱/索引
    participant S as 品牌官网 JSON-LD
    // 第一步:查询进入引擎,识别品牌实体意图
    U->>E: 「XX家政浦东店地址」
    // 第二步:按实体召回知识条目
    E->>G: 召回「XX家政」实体条目
    // 第三步:顺着组织树的边去解析门店归属
    G->>S: 解析组织树边(parentOrganization→@id)
    // 官网返回节点,边的两端 @id 必须严格一致
    S-->>G: 返回总部/区域/门店节点及属性
    // 归属成立后,门店事实进入答案候选池
    G-->>E: 门店归属为品牌实体,附带地址电话
    E-->>U: 「XX家政浦东店位于浦东南路…」
理解这条链路后就明白改造的杠杆点在哪:边是引擎自己爬不出来的,必须由站点声明。 语言模型再强,输入的候选条目里没有归属关系,它就只能靠名字猜。
误区澄清
两个常见误区收个尾。一是以为挂了 subOrganization 就万事大吉——图只是声明,@id 断链、节点字段矛盾、页面 404 都会让边解析失败,CI 里要有 JSON-LD 的持续校验,不是一次性的。二是把组织树当成万能药,门店页缺 geo、缺营业时间、地址写法不统一,这些基础事实层的问题不解决,归属对了答案照样错。组织树解决的是「是不是一家」,事实层解决的是「答得对不对」,两层都要硬。
实施顺序建议:先固定 @id 规范并全站扫一遍现状,再改总部页 @graph,然后逐区域铺门店页,每铺完一个区域复测一轮问句。期间任何 URL 改版需求先过 @id 影响评估。这套东西不复杂,复杂的是让 60 个门店页在几个月的迭代里保持图的一致性——把校验做成 CI 任务,才算真正落地。
有正在做多门店实体改造的同学,欢迎评论区交流 @id 规范和各引擎解析差异的实测细节。
参考与延伸
- Schema.org Organization 属性文档(含 subOrganization / parentOrganization 定义)
- Schema.org LocalBusiness 类型文档
- Google Search Central:理解页面结构化数据的运作方式
- JSON-LD 1.0 规范(@graph 与节点引用机制)
GEO · AI搜索 · Schema.org · subOrganization · parentOrganization · 组织树 · LocalBusiness · 连锁门店