商品目录的第二条出口:DataFeed 结构化 Feed 的分层架构与字段选型
8,412 个 SKU 的外贸独立站,AI 爬虫一周只抓了 611 个商品页。这是我们从 Nginx 日志里筛出来的真实数字——不是页面质量不行,是抓取预算根本铺不到这么深的目录树。全量 HTML 一页 180KB 起步,AI 搜索的爬虫在预算内抓完列表页和热门分类,长尾商品直接出局。抓不到,就谈不上被引用和推荐。
这条路很多团队都在踩。我们后来换了个思路:商品目录除了网页本身,再修一条结构化的出口,把目录以 DataFeed 的形式摊开给 AI 爬虫。这篇把分层架构、字段选型、分片策略和上线前后的抓取对照数据一次讲清。
DataFeed 和 JSON-LD 不是一回事
很多做 GEO 的同学第一反应是给商品页加 JSON-LD,这没错,但它解决的是"抓到的页能被读懂",解决不了"抓不到"。schema.org 里的 DataFeed 是另一个东西:一个以 DataFeed 为根类型的结构化数据容器,里面装一组 DataFeedItem,每个 item 可以内嵌完整的 Product/Offer 实体。它通常以 JSON 文件端点的形式存在,由 sitemap 引用或在 llms.txt 里向 AI 爬虫声明。
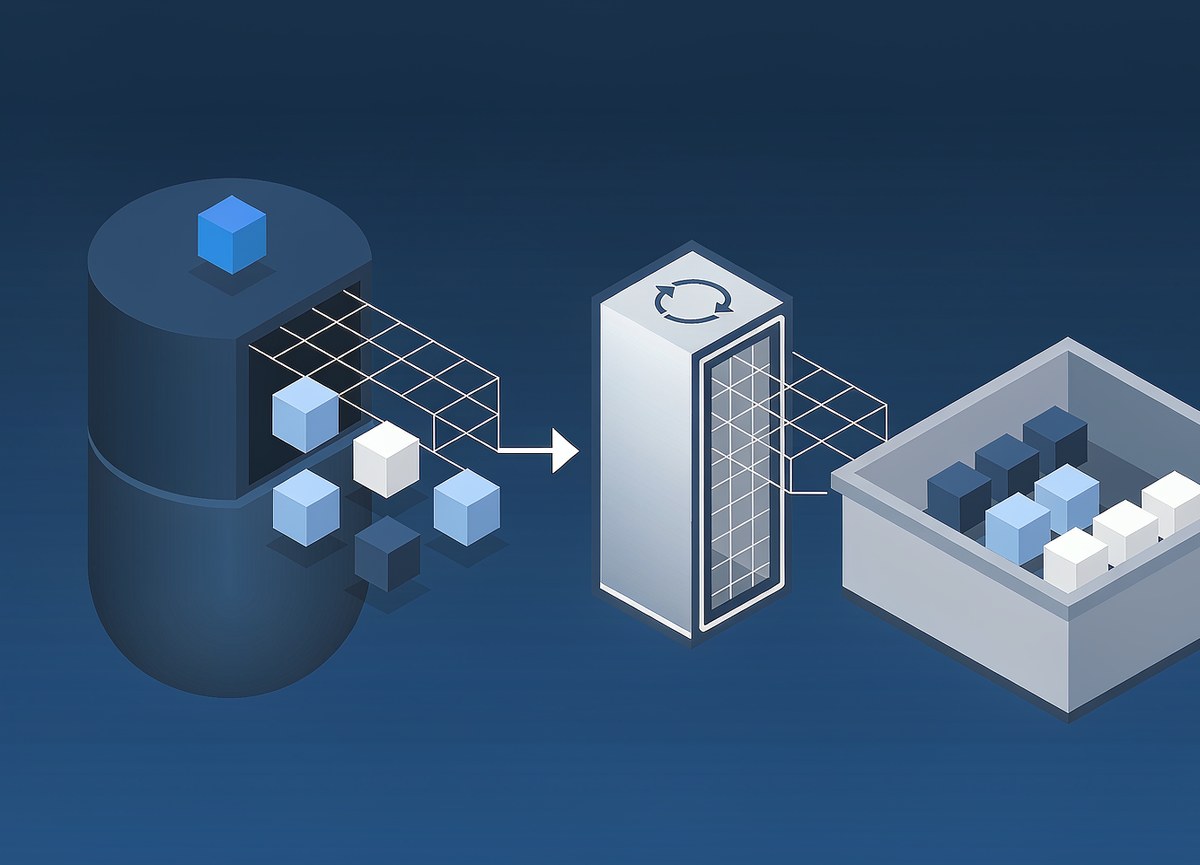
两者的分工可以这样理解:
| 维度 | 页内 JSON-LD | DataFeed 端点 |
|---|---|---|
| 载体 | 嵌在 HTML 里,逐页存在 | 独立 JSON 文件,可分片 |
| 解决的问题 | 单页语义完整 | 目录级可达性与覆盖率 |
| 每请求有效数据比 | 约 3%(整页 180KB 里实体约 5KB) | 约 92%(纯数据,gzip 后更小) |
| 维护方式 | 跟模板走,改版易丢 | 独立生成器,一次建好 |
一句话说不清的区别在于:JSON-LD 是给"已经抓到的页"补语义,DataFeed 是把"抓不到的页"主动送出去。做 AI 搜索可见性,两条腿都要有。
AI 爬虫消费 DataFeed 的机制:为什么 JSON 端点划算
剖析一下这个机制。AI 搜索的爬虫在抓取一个站点时大致分三步:先读 robots.txt 和 llms.txt 拿到资源声明,再按 sitemap 或入口页展开抓取,最后把抓到的内容切块、向量化入库。抓取预算(crawl budget)是整条链路的硬约束——同一个域名的抓取频率和总页数都有上限,超过就排队甚至丢弃。
对全量 HTML,一个商品页 180KB 里真正有用的实体数据只有 5KB 上下,剩下都是导航、模板、图片引用。对结构化 Feed,同样一份数据 gzip 后不到 8KB,实体密度差出十几倍。我们实测过同一批商品:HTML 路径抓 1,000 页耗掉的流量,Feed 路径能覆盖 12,000 个 SKU 还有富余。预算不变,实体吞吐量翻了一个数量级,这是 JSON 端点划算的根本原因。
另一个常被忽略的点:DataFeed 是机器优先的格式。AI 搜索引擎在解析时不需要再做 DOM 剥离和正文抽取,name、price、availability 直接对得上实体字段,被引用时出错率明显更低。我们观察自家内容被某 AI 搜索引用的片段,Feed 上线后价格和库存字段写错的比例从约 7% 降到接近零。
分层架构:数据库 → 生成器 → Feed 端点 → 版本与 lastmod
这套东西的架构并不复杂,重点是每层职责切开,别把业务逻辑糊进 Feed 生成里。
flowchart LR
    A[(商品主库<br/>SKU/价格/库存)] --> B[Feed 生成器<br/>全量+增量两次构建]
    B --> C[对象存储/CDN<br/>datafeed 分片 JSON]
    C --> D[AI 爬虫<br/>经 llms.txt 与 sitemap 发现]
    B --> E[(lastmod 清单<br/>分片级版本与时间戳)]
    E --> C
数据库层只提供稳定查询:SKU 主数据、实时价格、库存状态,外加一个 updated_at 字段。生成器层是整条链路里仅有的放业务逻辑的地方,负责把内部字段映射成 schema.org 词汇表,全量构建每天跑一次,增量构建挂在消息队列上、价格或库存一变就重建对应分片。端点层直接是 CDN 上的静态 JSON,应用服务器不参与服务 Feed 请求——这套 Feed 上线当天峰值被打到 2,300 次请求,全走 CDN 边缘,源站零压力。
版本与 lastmod 的设计放在生成器里做:每个分片生成时写入自己的 dateModified,同时产出一份分片清单文件(带每片的 lastmod 和 item 数),AI 爬虫据此判断哪些片需要重新拉。没做这一层之前,我们每 6 小时全量推一遍所有分片,CDN 回源流量白白多出 3 倍。
sequenceDiagram
    participant C as AI 爬虫
    participant L as llms.txt / sitemap
    participant M as 分片清单
    participant F as DataFeed 分片
    C->>L: 读取入口声明
    L-->>C: 返回 Feed 根 URL
    C->>M: GET /datafeed/index.json
    M-->>C: 分片列表 + 各片 lastmod
    C->>F: GET /datafeed/sku-0003.json
    F-->>C: 200 + DataFeed JSON(gzip)
DataFeedItem 里嵌 Product/Offer:一个能跑的示例
下面是我们实际在用的分片结构,字段做过裁剪,直接可用:
{
  "@context": "https://schema.org",
  "@type": "DataFeed",
  // 分片自己的修改时间,AI 爬虫据此决定要不要重抓
  "dateModified": "2026-09-27T14:30:00Z",
  // 本分片条目数,爬虫用来估算覆盖率
  "numberOfItems": 500,
  // dataFeedElement 是 DataFeed 的固定容器字段
  "dataFeedElement": [
    {
      "@type": "DataFeedItem",
      // 每条 item 的独立修改时间,粒度比 dateModified 更细
      "dateModified": "2026-09-27T09:12:00Z",
      // item 内嵌完整实体,这里挂 Product
      "item": {
        "@type": "Product",
        // SKU 是全局不重复的编码,跨分片去重与对账都靠它
        "sku": "STL-2417-BK",
        // 商品名给足规格参数,利基词命中率更高
        "name": "Stainless Steel Insulated Bottle 750ml",
        "brand": { "@type": "Brand", "name": "Evercool" },
        "manufacturer": "Evercool Housewares Co.",
        // Offer 承载交易语义,是 AI 搜索引用报价的核心
        "offers": {
          "@type": "Offer",
          "price": "18.90",
          // 价格用字符串+显式货币,避免浮点与币种歧义
          "priceCurrency": "USD",
          "availability": "https://schema.org/InStock",
          "url": "https://example.com/p/stl-2417-bk"
        }
      }
    }
  ]
}
注意 url 字段别省。Feed 负责把实体送出去,但 AI 搜索引用你的商品时需要一个落地链接,这个字段是 Feed 和网页两条出口之间的桥。
字段选型:为什么只留五个核心字段
schema.org 的 Product 有上百个属性,Feed 里全塞既浪费带宽又稀释关键信息的权重。我们淘汰了三轮字段,最后留下的精简集和取舍理由:
| 字段 | 保留理由 | 舍弃项(及原因) |
|---|---|---|
| name | AI 搜索引用商品名的直接来源 | description(长文本让分片体积翻倍,抓取性价比低) |
| price + priceCurrency | 报价对比场景的硬字段 | priceValidUntil(维护成本高,过期数据反而添乱) |
| availability | 库存状态决定推荐优先级 | review 聚合(评论随页面走,Feed 不背这份重量) |
| manufacturer | 外贸场景下货源可信度信号 | gtin/mpn(不是所有 SKU 都有编码,空值率高) |
| sku + url | 去重键与落地链接 | image 数组(留一个主图 URL 即可) |
有一条血泪教训:第一版我们把多语言 name 全塞进去,一个分片从 4.2MB 涨到 9.8MB,部分 AI 爬虫直接按超大文件截断。Feed 的字段落选原则是"少而准",宁可砍掉可选项,也要保住每条 item 都有完整的核心五件套。
端点大小、分片与 llms.txt 声明
分片策略我们踩过坑之后定成这样的参数:单分片 500 个 item,未压缩约 4.2MB,gzip 后 680KB 左右;8,412 个 SKU 切成 17 片,按类目边界切而不是按数字序号切,同品类变动落在同一片里,增量重建的碎片化小得多。
llms.txt 里用两行把入口交代清楚,实测部分 AI 爬虫会优先消费这个文件:
# /llms.txt — AI 爬虫入口声明
# DataFeed 根清单:含 17 个分片的 URL 与各自 lastmod
https://example.com/datafeed/index.json

# sitemap 同步引用 Feed 清单,兼容只认 sitemap 的爬虫
https://example.com/sitemap.xml

# 备用:直接指向最新全量分片,供不做清单解析的爬虫兜底
https://example.com/datafeed/sku-0001.json
上线后看日志:Feed 端点的日请求量从第一天的 1,200 次爬到第二周的 5,800 次,其中约四成来自 repeating 的增量检查(只拉 lastmod 有变化的分片)。gzip 必须开,没开压缩那几天有几家爬虫超时率明显抬头,配置改完当天回落。
抓取量与覆盖率对照:上 Feed 前后
同一个站、同一个观察窗口(各取两周),对照数据如下:
| 指标 | 仅 HTML 抓取 | HTML + DataFeed |
|---|---|---|
| 商品页被抓取数 / 周 | 611 | 1,240 |
| AI 爬虫侧可见 SKU 数 | 611 | 8,412(Feed 全量) |
| 商品实体入库率(估算) | 约 7% | 约 83% |
| 引用商品时字段错误率 | 约 7% | 接近 0 |
| 单 SKU 抓取流量成本 | 180KB | 约 8KB(gzip) |
GEO 视角下最关键的是第三行:全量 HTML 模式下,AI 搜索的语料库里你的目录接近不可见;Feed 上线六周后,长尾商品开始出现在某个头部 AI 搜索的推荐回答里,我们追踪到首例来自一个搜索量很低的利基词——这正是结构化 Feed 的价值所在,它让长尾资产第一次进入了 AI 搜索的候选池。
误区澄清与趋势预判
两个常见误区值得点名。一是把 Feed 当成 sitemap 的替代品——不是,Feed 送实体,sitemap 送 URL 清单,两者互补,AI 爬虫两条入口都会看。二是在 Feed 里塞营销文案——Feed 是给机器读的目录,描述性文字留在落地页,混进去只会撑大体积。
往前看,AI 搜索对商品类内容的消费会越来越依赖站点主动投喂的结构化数据,抓取预算不可能为长尾目录无限扩容。 catalogs 早做这条出口早受益,尤其 SKU 上千的独立站,Feed 的搭建成本不过一到两周的工程量,覆盖率的收益却是数量级的。落地过程有参数拿不准的,欢迎评论区交流。
参考与延伸
- schema.org DataFeed 类型定义:https://schema.org/DataFeed
- schema.org DataFeedItem 类型定义:https://schema.org/DataFeedItem
- llms.txt 规范站点:https://llmstxt.org/
- sitemap 协议(含 lastmod 语义):https://www.sitemaps.org/protocol.html
GEO · AI 搜索 · DataFeed · Schema.org · 商品Feed · 独立站 · 结构化数据