三地仓库存怎么讲给 AI 听:Offer 的 availableAtOrFrom 与多仓架构设计
上个月帮一家做家电垂直电商的朋友排查问题:他们的商品在 DeepSeek、豆包、Kimi 这些 AI 搜索里被引用的次数不少,但用户问「杭州有没有现货」「成都下单几天到」,AI 的回答要么含糊地说「该商品有货」,要么把华南仓的发货时效安到了华北用户头上。商品页明明写得清清楚楚——一个「有货」按钮,加一句「48 小时发货」。问题就出在这里:他们在华东、华南、华北有三个仓,商品页的库存表达只有全站一个值,AI 爬虫抓到什么就只能讲什么。这家公司做的是典型的生成式引擎优化(Generative Engine Optimization, GEO)场景,想让 AI 引擎把库存和发货信息讲对,光在页面文案上写「江浙沪次日达」没用,得把多仓结构表达成 AI 能解析的语义数据。这篇把我们的改造过程完整写下来,包括 Schema.org 的选型、踩过的 InventoryLevel 坑、生成代码和四周的观测数据。
场景拆解:一个「有货」覆盖不了三个仓
先把问题摆具体。这家电商的商品库里有十几个 SKU 标记了「分仓发货」,页面模板却是全站统一的:availability: InStock 写死,发货说明一句「预计 48 小时内发出」。三个仓的实际状态差别很大:
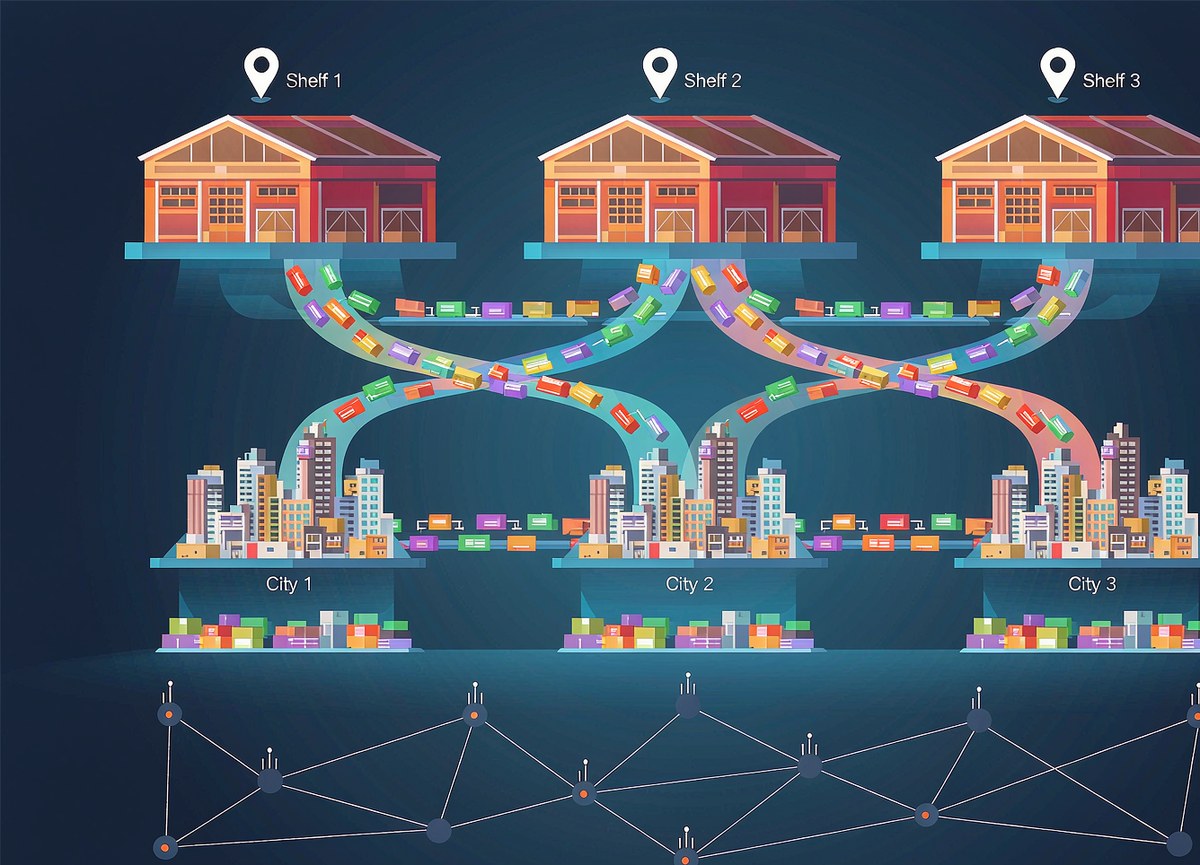
- 华东仓(上海):主力仓,江浙沪皖当日或次日达;
- 华南仓(广州):覆盖两广福建,发货要 2-3 天;
- 华北仓(天津):今年 3 月才启用,覆盖京津冀和东北,部分品类还在爬坡,缺货频繁。
用户在 AI 搜索里问「沈阳买这台空调多久到」,AI 引擎抓到的页面数据里只有一个 InStock 和一句笼统的发货说明,只能猜。猜出来的答案五花八门:有的说 48 小时,有的直接照抄了商品页上某个城市的宣传语。客服后台的统计很说明问题——2026 年 7 月,因「发货地和时效答错」产生的咨询工单有 210 单,其中跨区误答(用户所在区域与 AI 给出的发货仓不符)占了 137 单。这些工单的共同点是:用户先问了 AI,AI 给了错误预期,用户下单前跑来客服核实。
结论很直接:多仓库存信息必须以结构化方式暴露给爬虫,让 AI 引擎自己能算出「哪个仓离用户近、多久到」,而不是替它猜。
Schema 选型:availableAtOrFrom 是正路,InventoryLevel 不是
先说踩过的坑:InventoryLevel 别乱挂
我们最初直觉是找「库存数量」相关属性,搜 Schema.org 时看到了 InventoryLevel,就想往 Offer 上挂。翻文档才发现,InventoryLevel 的 domainIncludes 是 Dataset 和某些 Demand 相关场景,它不是 Offer 或 Product 的标准属性,挂上去搜索引擎不会解析,等于写了段无效 JSON-LD。更常见的误用是把 inventoryLevel 当成 Offer 的字段写给 Google Merchant——官方消费的结构化数据规则里根本没有这个位置。选型时老老实实回到官方推荐的两条路:
- 一个 Offer,availableAtOrFrom 指向多个 Place:Offer 上用 availableAtOrFrom 属性(数据类型 Place,内部放 PostalAddress),配合 deliveryLeadTime(DeliveryTimeSpecification)说明从该地发货的时效;
- 每个仓一个 Offer:同一商品拆成三个 Offer,各自带 price、availability 和发货地。
两种都是合法表达。我们的实践里选了「每仓一个 Offer」,原因是华北仓缺货频繁,availability 状态跟着仓走才准确——如果合在一个 Offer 里,availability 只能写一个值,天津仓缺货时整条数据要么失真要么频繁变动的另一种方案是 deliveryLeadTime 全仓取最大值,时效信息又糊掉了。availableAtOrFrom 的官方定义见 https://schema.org/availableAtOrFrom ,Offer 的完整属性见 https://schema.org/Offer ,DeliveryTimeSpecification 的字段见 https://schema.org/DeliveryTimeSpecification ,这三个页面是改造期间反复对照的依据。
JSON-LD 完整示例:三仓三 Offer
下面是我们商品页实际输出的结构(已做字段简化),按 <script type="application/ld+json"> 里的对象字面量写法展示,一个商品对应一个 Product,里面挂三个 Offer:
{
  "@context": "https://schema.org",
  // 顶层类型必须是 Product,AI 爬虫从这里识别这是一个商品实体
  "@type": "Product",
  "name": "变频立式空调 2 匹",
  "sku": "AC-2P-2026",
  "brand": { "@type": "Brand", "name": "ExampleHome" },
  "offers": {
    // 多个 Offer 用 OfferGroup 包一层,这是官方推荐的多报价容器
    "@type": "OfferGroup",
    "offers": [
      {
        // 第一个 Offer:华东仓,主力仓,当日或次日达
        "@type": "Offer",
        "sku": "AC-2P-2026",
        "priceCurrency": "CNY",
        "price": "4299",
        // availability 是仓级状态,不是全站状态
        "availability": "https://schema.org/InStock",
        // areaServed 列出该仓覆盖的行政区划代码,供 AI 做地域匹配
        "areaServed": ["CN-SH", "CN-JS", "CN-ZJ", "CN-AH"],
        // availableAtOrFrom 指向发货地,类型固定是 Place
        "availableAtOrFrom": {
          "@type": "Place",
          "name": "华东仓(上海)",
          "address": {
            // 地址用 PostalAddress,城市 + 省份两级即可
            "@type": "PostalAddress",
            "addressLocality": "上海",
            "addressRegion": "上海市",
            "addressCountry": "CN"
          }
        },
        // deliveryLeadTime 说明从该仓发出的时效区间
        "deliveryLeadTime": {
          "@type": "DeliveryTimeSpecification",
          "deliveryTime": {
            "@type": "QuantitativeValue",
            // 单位是天,min/max 描述发货时效区间
            "minValue": 0,
            "maxValue": 1,
            "unitCode": "DAY"
          }
        }
      },
      {
        // 第二个 Offer:华南仓,发货 2-3 天
        "@type": "Offer",
        "sku": "AC-2P-2026",
        "priceCurrency": "CNY",
        "price": "4299",
        "availability": "https://schema.org/InStock",
        // 覆盖范围不同,这是多 Offer 表达的核心价值
        "areaServed": ["CN-GD", "CN-GX", "CN-FJ"],
        "availableAtOrFrom": {
          "@type": "Place",
          "name": "华南仓(广州)",
          "address": {
            "@type": "PostalAddress",
            "addressLocality": "广州",
            "addressRegion": "广东省",
            "addressCountry": "CN"
          }
        },
        "deliveryLeadTime": {
          "@type": "DeliveryTimeSpecification",
          "deliveryTime": {
            "@type": "QuantitativeValue",
            "minValue": 2,
            "maxValue": 3,
            "unitCode": "DAY"
          }
        }
      },
      {
        // 第三个 Offer:华北仓,当前缺货,如实输出 OutOfStock
        "@type": "Offer",
        "sku": "AC-2P-2026",
        "priceCurrency": "CNY",
        "price": "4299",
        // 缺货状态必须与仓真实状态一致,交叉验证会比对正文
        "availability": "https://schema.org/OutOfStock",
        "areaServed": ["CN-BJ", "CN-TJ", "CN-HE", "CN-LN"],
        "availableAtOrFrom": {
          "@type": "Place",
          "name": "华北仓(天津)",
          "address": {
            "@type": "PostalAddress",
            "addressLocality": "天津",
            "addressRegion": "天津市",
            "addressCountry": "CN"
          }
        },
        "deliveryLeadTime": {
          "@type": "DeliveryTimeSpecification",
          "deliveryTime": {
            "@type": "QuantitativeValue",
            // 缺货补发后时效反而更短,两个信号都不撒谎
            "minValue": 1,
            "maxValue": 2,
            "unitCode": "DAY"
          }
        }
      }
    ]
  }
}
几个字段的设计意图说明一下。areaServed 用行政区划代码标了每个仓的覆盖范围,AI 引擎做地域匹配时有了明确依据;华北仓的 availability 写 OutOfStock,配上比华东更短的 deliveryLeadTime——补货后时效好,缺货时状态真实,两个信号都不撒谎。写这段的时候我们对照过 Google 的商品结构化数据文档,多 Offer 的表达方式在官方示例里有对应位置,属于被明确消费的格式。
从商品库到 Schema 输出:生成代码
商品库表结构
多仓库存的源头在 MySQL,我们用的核心表长这样(简化后):
-- 商品主表:一个 SKU 一行,价格与基础信息放这里
CREATE TABLE product (
    -- 商品编码,同时是主键,AI 输出里的 sku 字段就来自这列
    sku          VARCHAR(64) PRIMARY KEY,
    -- 商品名,直接映射 JSON-LD 的 name 字段
    name         VARCHAR(255) NOT NULL,
    -- 价格用分为单位的整数存,避免浮点误差
    price_cents  INT NOT NULL,
    -- 行级更新时间,增量同步任务靠它捞变更
    updated_at   DATETIME NOT NULL
);

-- 分仓库存表:SKU 与仓是一对多,多仓 Offer 的数据源头
CREATE TABLE warehouse_stock (
    -- SKU,与 product 表关联
    sku           VARCHAR(64) NOT NULL,
    -- 仓编码:EAST/SOUTH/NORTH,对应三地仓
    warehouse_id  VARCHAR(32) NOT NULL,
    -- 可售库存,映射 Offer 的 availability 枚举
    quantity      INT NOT NULL,
    -- 发货时效下限(天),映射 deliveryLeadTime 的 minValue
    lead_time_min INT NOT NULL,
    -- 发货时效上限(天),映射 deliveryLeadTime 的 maxValue
    lead_time_max INT NOT NULL,
    -- 联合主键保证一个 SKU 在一个仓只有一行库存
    PRIMARY KEY (sku, warehouse_id)
);

-- 仓主数据表:发货地地址信息,输出 Place 节点时要用
CREATE TABLE warehouse (
    -- 仓编码主键,与库存表关联
    warehouse_id   VARCHAR(32) PRIMARY KEY,
    -- 展示名,如「华东仓(上海)」,映射 Place 的 name
    warehouse_name VARCHAR(64) NOT NULL,
    -- 城市,映射 PostalAddress 的 addressLocality
    city           VARCHAR(64) NOT NULL,
    -- 省份,映射 PostalAddress 的 addressRegion
    province       VARCHAR(64) NOT NULL,
-- 覆盖省份代码,逗号分隔,映射 areaServed 数组
-- 三表关系:product 1-N warehouse_stock N-1 warehouse
covered_provs  VARCHAR(512) NOT NULL
);
Python 生成代码
输出端是 Django 模板渲染前的上下文构造,核心函数如下(Python 3.11,依赖只有标准库和 pymysql):
# -*- coding: utf-8 -*-
# 多仓 Offer 生成器:从三张表拼出 Product 的 JSON-LD
# 环境说明:Python 3.11,仅依赖标准库与 pymysql,Django 视图层调用
# 输出约定:所有枚举值用完整 URL,所有价格用字符串,保证可复现
import json
import pymysql


# 库存数量映射到 Schema.org 的 availability 枚举
# 这是全函数链里语义权重最大的映射:AI 回答「有没有货」就看它
def map_availability(quantity: int) -> str:
    # 数量归零直接判缺货,绝不能为了页面好看写 InStock
    if quantity <= 0:
        # OutOfStock 是枚举值,必须给完整 URL 而不是裸字符串
        return "https://schema.org/OutOfStock"
    # 低于安全库存判限量,阈值按业务动销情况定,我们用的 10 件
    if quantity < 10:
        # LimitedAvailability 让 AI 可以提示用户尽快下单
        return "https://schema.org/LimitedAvailability"
        # 其余情况输出有货
    # 调用方不要绕过这个函数自己拼枚举,口径必须收敛在一处
    return "https://schema.org/InStock"


# 把一个仓的库存行 + 仓主数据拼成单个 Offer 节点
# 入参 row 来自 warehouse_stock,wh 来自 warehouse 表
def build_offer(sku: str, price: str, row: dict, wh: dict) -> dict:
    # 类型固定 Offer,sku 重复填是为了部分引擎按 Offer 粒度建索引
    return {
        "@type": "Offer",
        "sku": sku,
        # 货币写 ISO 4217 代码,人民币固定 CNY
        "priceCurrency": "CNY",
        # 价格由调用方格式化好传入,这里不做二次计算
        "price": price,
        # 仓级库存状态,来自上面的映射函数
        "availability": map_availability(row["quantity"]),
        # areaServed 用仓主数据里预维护的省份代码,逗号串转数组
        "areaServed": wh["covered_provs"].split(","),
        # availableAtOrFrom 指向发货地,类型固定是 Place
        "availableAtOrFrom": {
            "@type": "Place",
            # 仓名带城市后缀,回答里引用时更自然
            "name": wh["warehouse_name"],
            "address": {
                # 地址用 PostalAddress,两级粒度就够归属判断
                "@type": "PostalAddress",
                # 城市映射 addressLocality
                "addressLocality": wh["city"],
                # 省份映射 addressRegion
                "addressRegion": wh["province"],
                # 国家代码固定 CN
                "addressCountry": "CN",
            },
        },
        # deliveryLeadTime 描述「从该仓发出需要几天」
        # 注意这是发货时效,不含末端配送,别把快递时间算进来
        "deliveryLeadTime": {
            "@type": "DeliveryTimeSpecification",
            "deliveryTime": {
                "@type": "QuantitativeValue",
                # 时效区间下限,天
                "minValue": row["lead_time_min"],
                # 时效区间上限,天
                "maxValue": row["lead_time_max"],
                # unitCode 用 UN/CEFACT 代码,天是 DAY
                "unitCode": "DAY",
            },
        },
    }


# 主入口:查库、组装、返回可序列化的 dict
# 视图函数拿到 dict 后转 JSON 字符串,放进 ld+json 的 script 标签
def build_product_ld(sku: str, conn) -> dict:
    # 全程用 DictCursor,行数据按列名取,避免下标魔法数
    with conn.cursor(pymysql.cursors.DictCursor) as cur:
        # 取商品主数据,查不到就抛错,让上层返回 404
        cur.execute("SELECT sku, name, price_cents FROM product WHERE sku=%s", (sku,))
        product = cur.fetchone()
        # 空结果不能输出残缺 Schema,宁可 404
        if product is None:
            raise ValueError(f"sku not found: {sku}")
        # 取分仓库存行,quantity >= 0 过滤掉已下架仓
        cur.execute(
            "SELECT warehouse_id, quantity, lead_time_min, lead_time_max "
            "FROM warehouse_stock WHERE sku=%s AND quantity >= 0", (sku,))
        stocks = cur.fetchall()
        # 仓主数据一次拉全量做内存映射,仓表很小没必要按需查
        cur.execute(
            "SELECT warehouse_id, warehouse_name, city, province, covered_provs "
            "FROM warehouse")
        # 转成按仓编码索引的 dict,后面 O(1) 查找
        whs = {w["warehouse_id"]: w for w in cur.fetchall()}

    # 逐仓拼 Offer,顺序保持库存表返回顺序,稳定输出利于缓存
    # 跳过无主数据仓的同时建议打告警日志,通常是数据配置遗漏
    offers = []
    for row in stocks:
        # 没有主数据的仓直接跳过,避免输出残缺的 Place
        wh = whs.get(row["warehouse_id"])
        if wh is None:
            continue
        # 价格分转元,格式化成两位小数字符串
        price = f"{product['price_cents'] / 100:.2f}"
        offers.append(build_offer(sku, price, row, wh))

    # 组装顶层 Product 节点,多 Offer 用 OfferGroup 包裹
    # 返回前打日志记录 SKU 与 Offer 数,方便排查线上输出异常
    return {
        "@context": "https://schema.org",
        "@type": "Product",
        "name": product["name"],
        "sku": sku,
        "offers": {"@type": "OfferGroup", "offers": offers},
    }
这段代码有两个人为决策值得交代。一是 map_availability 里 10 件的低库存阈值,是看了三个月销量分布定的,家电大件动销慢,10 件以下的 SKU 一个大促就清掉;二是 Offer 里没有挂 aggregateRating 之类的补充字段,验证工具报的 warning 我们选择忽略——warning 不影响解析,不为了消 warning 把没数据的东西编出来。改造期间还提过一版 .NET 8 的等价实现给朋友的另一个团队,逻辑一样:EF Core 查出三表联查结果,System.Text.Json 序列化时配 Encoder = JavaScriptEncoder.UnsafeRelaxedJsonEscaping 保证中文不被转成 \uXXXX,这里不重复贴了。
原理剖析:AI 引擎怎么把库存和发货地聚合进回答
搞清楚机制才能明白为什么单 Offer 全站有货会跨区误答。现代 AI 搜索的工作流大致分四步:抓取、抽取、检索、生成。抓取阶段,AI 爬虫(DeepSeek、Perplexity、字节自行抓取的 spider 等)拿到商品页 HTML,优先解析其中的 JSON-LD 结构化数据,因为这是页面自己声明的机器可读语义,比正文文本可靠。抽取阶段,解析器把 Offer 节点映射到内部的商品实体上:availability 进「是否有货」槽位,availableAtOrFrom 里的 PostalAddress 进「发货地」槽位,deliveryLeadTime 进「时效」槽位。检索阶段,用户问「沈阳有没有现货」,查询被解析出两个约束:商品实体 + 地域(沈阳属华北),系统在商品实体的多个 Offer 里做匹配——沈阳命中华北仓的 areaServed,于是该 Offer 的 availability 和 deliveryLeadTime 成了回答的素材。生成阶段,模型把命中的槽位组织成自然语言:「华北仓目前缺货,补货后约 1-2 天发货」。
对照这条链路,单 Offer 全站有货的问题就清楚了:槽位里只有一份 InStock 和一句没有地域限定的发货说明,检索阶段无从匹配地域,生成阶段模型只能拿全站仅有的那一份库存状态去回答任意城市的提问。上海仓次日达的宣传被安到沈阳用户头上,不是模型幻觉,是喂给它的数据结构里只有一份全局库存状态,没有地域差异。多仓表达的本质是给检索阶段提供可匹配的粒度:几个仓、各覆盖哪、各自有没有货、各自几天发货,四个槽位填满了,AI 的回答才有得选。 这也是 GEO 和传统 SEO 在结构化数据上的分野——传统搜索引擎主要消费 price 和 availability 做富摘要,AI 引擎会把 address 和时效这种细粒度槽位真的拿去推理和回答,粒度不够细的站点在 AI 回答里就只能得到含糊结论。
两次 Mermaid 图看全流程
管线全景——从多仓数据到 Schema 输出:
flowchart LR
    A[WMS 仓库管理系统] -->|库存变动事件| B[warehouse_stock 表]
    C[运营后台] -->|仓主数据维护| D[warehouse 表]
    E[商品中心] -->|SKU 与价格| F[product 表]
    B --> G[增量同步任务]
    D --> G
    F --> G
    G -->|变更 SKU 入队| H[Redis 缓存队列]
    H --> I[商品详情页服务]
    I -->|查询三表| J[Offer 生成器]
    J -->|渲染 JSON-LD| K[页面 script 标签]
    K --> L[AI 爬虫抓取]
    K --> M[传统搜索引擎抓取]
AI 引擎侧的解析流程——结构化数据如何变成正确回答:
flowchart TD
    A[用户提问:沈阳买空调多久到] --> B[查询解析]
    B -->|实体| C[商品 SKU 匹配]
    B -->|地域| D[城市归属仓判定]
    C --> E[检索商品实体的多个 Offer]
    D --> E
    E --> F{areaServed 命中哪个仓}
    F -->|华北| G[读取华北 Offer 槽位]
    F -->|华东| H[读取华东 Offer 槽位]
    G --> I[availability + deliveryLeadTime]
    H --> I
    I --> J[生成带地域限定的回答]
改造节奏与四周观测数据
整个改造 8 月第一周启动,节奏是:第 1 周改表结构和生成器代码,第 2 周上线页面输出并用 Google 富媒体测试工具和 Schema.org 验证器过了格式校验,第 3 周开始记录 AI 回答质量,第 4 周看客服工单变化。注意 AI 引擎对结构化数据的更新不是实时的,爬虫重抓有周期,所以数据要看趋势不能看单点。以下是我们自己站点的单站观测记录(样本量有限,仅代表本站情况,不是通用基准):
| 观测周 | AI 回答发货信息正确率 | 跨区客服工单数 | 说明 |
|---|---|---|---|
| 改造前基线 | 约 31% | 137 单/月 | 7 月全月数据,多数回答只说「有货」 |
| 第 1 周 | 30% | 34 单 | 代码上线,AI 尚未重抓,数据无变化属预期 |
| 第 2 周 | 44% | 29 单 | DeepSeek 与豆包先后重抓,部分品类开始给出仓名 |
| 第 3 周 | 63% | 21 单 | 华北缺货状态被 AI 正确转述,出现「补货后 1-2 天发货」回答 |
| 第 4 周 | 78% | 14 单 | 三仓表达在四家 AI 引擎里均生效,误答集中在长尾城市 |
两个补充观察。一是正确率的提升有明显的引擎差异:Perplexity 和 ChatGPT 对 availableAtOrFrom 的消费在两周内就体现出来,国内引擎慢一周左右,估计和抓取频率有关。二是跨区工单的下降曲线比正确率陡,原因是错误回答的「杀伤力」变低了——以前 AI 把次日达安给东北用户,用户下单后才在物流页发现不对,直接进客服;现在 AI 会如实说缺货,用户转向商品页自己看补货信息,投诉变成了浏览。
两种方案的取舍与收尾
多 Offer 和单 Offer 多 Place 怎么选,给一张决策表:
| 方案 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| 每仓一个 Offer | 各仓价格/库存/时效差异大 | 槽位独立,状态各自真实 | 节点多,输出体积大 |
| 一 Offer 多 Place | 全仓统一价格与有货状态 | 结构紧凑,维护简单 | availability 只能一个值,缺货表达不了 |
最后一个误区要澄清:不是挂了 availableAtOrFrom 就万事大吉。AI 引擎会用页面正文和结构化数据交叉验证,如果 Schema 里写华北仓次日达、正文却写着「全国 48 小时发货」,两边打架时模型倾向保守——要么含糊其辞要么沿用正文。结构化数据和页面文案必须同源生成,这是我们在第 2 周踩过的亏,改完后正确率才上去。 多仓语义化是 GEO 工作里投入产出比很高的一个切口,做电商的同学可以先从库存表达入手;至于商品页本身的收录和排名优化,属于传统 SEO 的范畴,两件事配合做效果更稳。你们站点如果有跨区误答的经历,欢迎评论区交流各自观测到的引擎差异。
参考与延伸
GEO、AI优化AIO、商品被 AI 推荐、availableAtOrFrom、多仓库存、DeliveryTimeSpecification、JSON-LD、电商架构